일본 AI 회사 higurashi가 11월 12일 공개한 음성 AI Haru-4B는 사람 말을 들으면서 동시에 말하는 풀듀플렉스 모델입니다. M1 Max 맥북에서 사용자 소리가 들어와 모델 목소리가 헤드폰으로 나가기까지 65.2ms(중앙값)가 걸렸고 실제 녹음 4,000만 시간으로 학습했습니다.
숫자만 보면 기존 공개 모델보다 훨씬 빠릅니다. 그러나 소리를 133ms 단위로 끊어 받는 대기까지 더하면 최대 198.2ms로 2024년 프랑스 Kyutai의 Moshi가 밝힌 실사용 지연 200ms와 비슷해집니다(다대구 계산). 저는 Haru-4B가 바꾼 것이 속도 숫자보다 대화 습관을 배우는 방식에 있다고 봅니다.
1. 풀듀플렉스 음성 AI Haru-4B, 일본 정부 지원 사업에서 나왔다
지금 쓰는 음성 비서는 대부분 내 말이 끝나기를 기다렸다가 글로 바꾸고 답을 만든 뒤 다시 소리로 읽어 줍니다. 풀듀플렉스 모델은 전화 통화처럼 듣기와 말하기를 한꺼번에 처리해 상대가 말하는 도중에 맞장구를 치거나 끼어든 말에 바로 반응합니다.
Haru-4B는 알리바바의 언어 모델 Qwen3.5-4B를 바탕으로 만들었습니다. 깃허브 저장소는 11월 12일, 기술 블로그는 11월 13일에 올라왔고 코드와 가중치는 모두 상업적 사용이 가능한 Apache 2.0 라이선스입니다. 허깅페이스에 올라온 가중치 파일 기준 매개변수는 약 52억 7,000만 개입니다.
개발비 쪽도 적혀 있습니다. higurashi는 아마존웹서비스(AWS)와 일본 경제산업성·신에너지산업기술종합개발기구(NEDO)가 운영하는 생성 AI 지원 사업 GENIAC의 지원을 받았다고 밝혔습니다. 정부 사업이 키운 모델을 곧바로 공개 라이선스로 푼 것은 일본이 음성 AI 기반 모델을 공공재처럼 깔아 두려는 선택이라고 봅니다.
2. 맥북에서 65.2ms, 133ms 대기를 더하면 Moshi와 비슷하다
higurashi가 M1 Max 맥북과 유선 마이크·헤드폰, 8비트(int8) 가중치로 잰 지연은 65.2ms입니다. 이 가운데 모델이 한 단계를 계산하는 시간이 34.2ms로 52.5%를 차지합니다(다대구 계산).
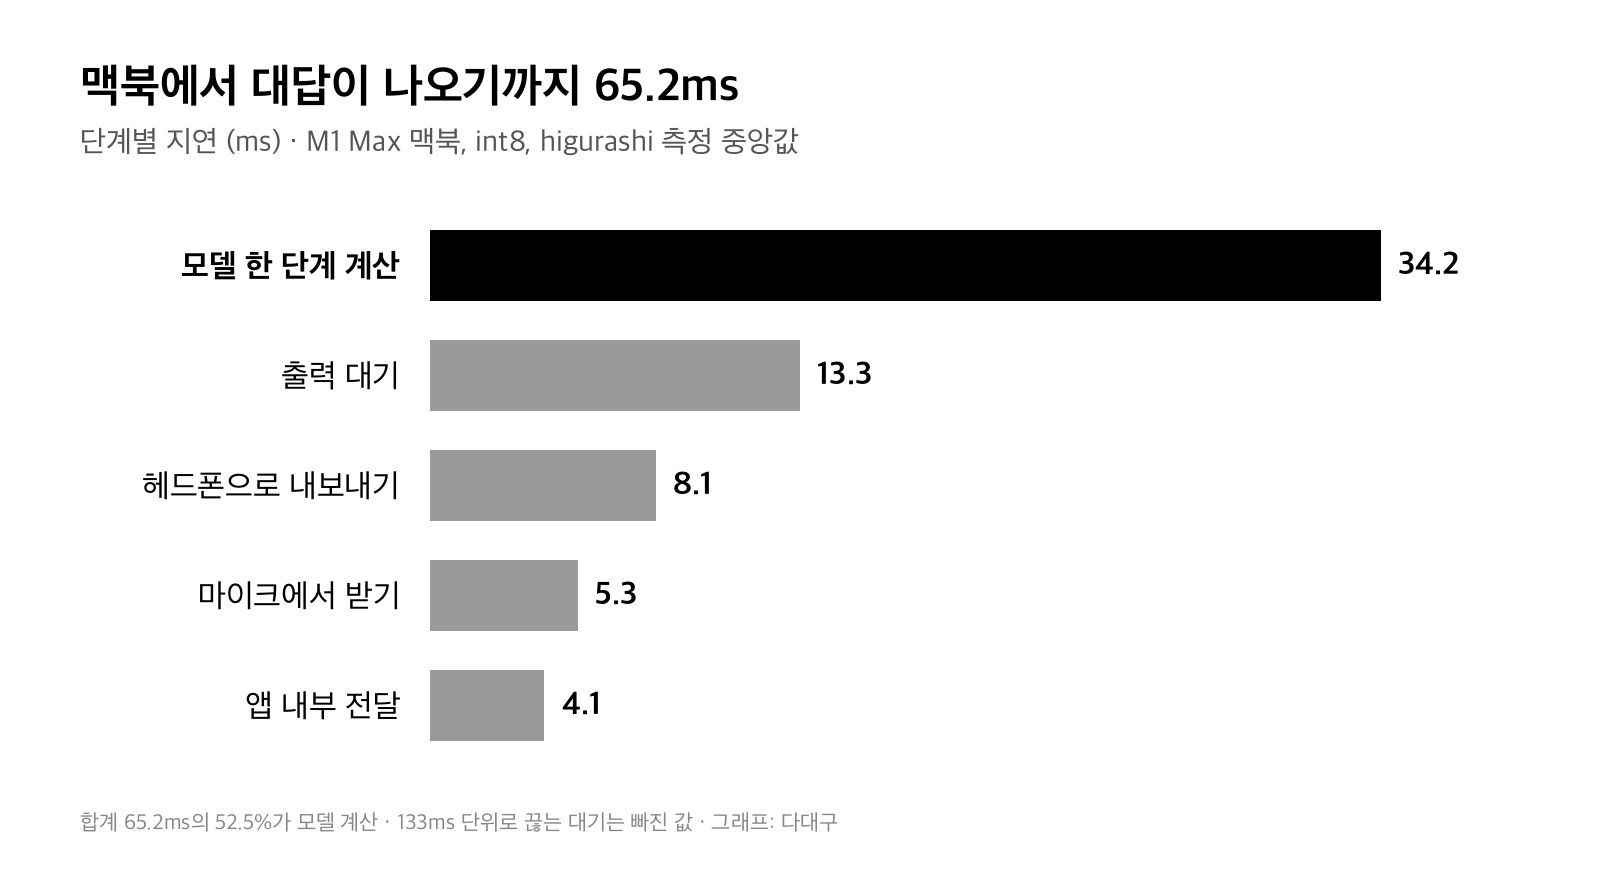
다만 이 숫자에는 빠진 시간이 있습니다. Haru는 1초를 7.5칸으로 나눠 133ms마다 소리 한 덩어리를 받기 때문에 회사도 최대 133ms가 더 걸릴 수 있다고 적었습니다. 이를 더하면 최대 198.2ms이고 Moshi 논문이 밝힌 이론 지연 160ms, 실사용 지연 200ms와 큰 차이가 없습니다.
대신 계산 횟수는 줄었습니다. Moshi는 1초에 12.5번 소리를 만들고 Haru는 7.5번 만들어 같은 길이의 말을 40% 적은 단계로 처리합니다(다대구 계산). 엔비디아 B300 서버에서는 소리 변환과 모델 한 단계가 합쳐 약 15ms라고 했습니다.
국내 연구와 비교하면 차이가 분명합니다. 김동영·정민주·김재은 연구팀이 2025년 한국소프트웨어종합학술대회에서 발표한 연결식 음성 대화 구조는 음성 인식·언어 모델·음성 합성을 겹쳐 돌려 응답 지연을 650ms 수준으로 낮췄습니다.
측정 조건이 다르지만 Haru의 65.2ms는 그 10분의 1입니다(다대구 계산). 저는 끝없는 속도 경쟁보다 133ms 단위 구조가 대화에 충분한지가 다음 질문이라고 봅니다.
3. 실제 녹음 4,000만 시간, 합성 대화는 일부러 뺐다
Haru-4B는 160개가 넘는 언어, 4,000만 시간이 넘는 실제 음성으로 학습했습니다. 영어·스페인어·포르투갈어·독일어·프랑스어·중국어·일본어·러시아어·한국어 9개를 중심 언어로 삼았고 언어 모델이 만든 대화나 음성 합성으로 만든 소리는 학습 데이터에서 뺐다고 밝혔습니다.
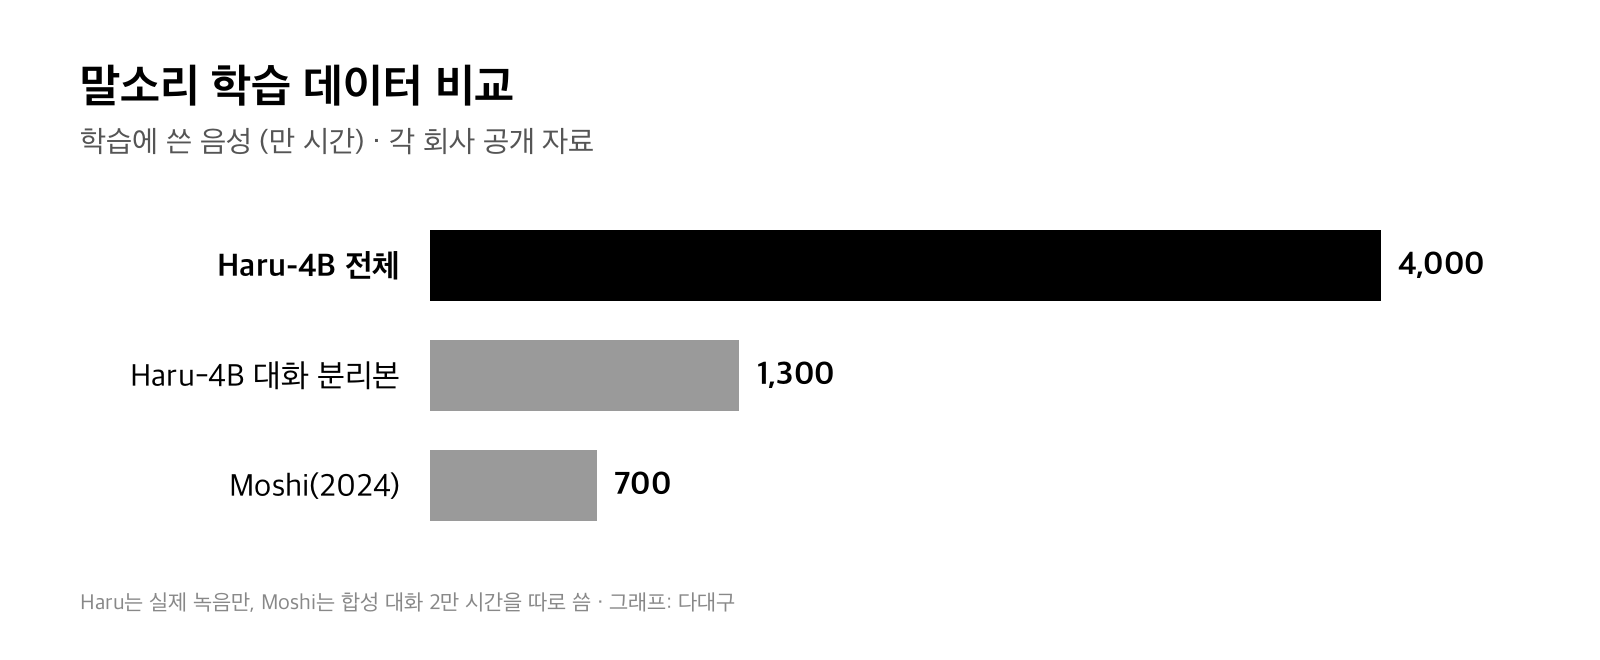
비교 대상인 Moshi는 700만 시간 음성으로 먼저 학습한 뒤 직접 만든 합성 대화 2만 시간 이상을 더해 대화를 가르쳤습니다. Haru의 학습 음성은 Moshi의 5.7배입니다(다대구 계산).
어려운 대목은 두 사람 목소리가 한 줄에 섞인 녹음이었습니다. higurashi는 섞인 녹음을 화자별로 나누고 잡음을 걷어 내는 모델 FastDialogueSidon을 따로 만들어 1,300만 시간이 넘는 대화를 두 줄로 분리했습니다. 전체 학습 음성의 32.5%이고 한 번에 최대 60분짜리 대화까지 넣었습니다(다대구 계산).
학습에는 엔비디아 B200 256장을 약 8일 썼습니다. GPU 한 장을 한 시간 쓰는 단위로 바꾸면 약 4만 9,152시간입니다(다대구 계산). 사람이 실제로 머뭇거리고 겹쳐 말하는 소리를 그대로 배운 점이 이 모델의 핵심 차별점이라고 봅니다.
4. 맞장구와 끼어들기, 빠를수록 좋은 대답은 아니다
공개 데모에서 Haru는 상대가 맞장구치는 동안 말을 이어 가고 진지한 질문에는 말투를 바꿉니다. 대화 내용에 맞춰 쉬는 시간을 다르게 둔다는 뜻입니다.
이 지점은 국내 연구와 이어집니다. 조다영·최준호 연구팀이 2026년 한국콘텐츠학회논문지에 낸 실험에서 20~30대 63명은 정보를 알려 주는 AI의 3초 휴지를 신중함으로 받아들여 신뢰를 4.3점으로 매겼습니다. 같은 3초 휴지가 심리 상담에서는 단절로 읽혀 신뢰가 2.3점으로 떨어졌습니다.
연구팀은 과업형 대화에는 1~3초 휴지를, 관계형 대화에는 즉시 응답을 권했습니다. 저는 Haru 같은 모델이 쓸모 있으려면 지연을 줄이는 능력보다 언제 기다리고 언제 끼어들지 고르는 능력이 더 중요하다고 봅니다.
5. 직접 써 보려면, 메모리 16GB 맥과 목소리 권리부터 확인
엔비디아 그래픽카드에서는 메모리 약 12GB면 웹 데모를 띄울 수 있습니다. 애플 실리콘 맥용 앱은 macOS 13 이상에서 돌아가고 모델 파일이 약 10GB라 메모리 16GB가 사실상 최소라고 안내합니다.
목소리는 3초에서 3분 길이의 한 사람 음성 파일로 정합니다. 남의 목소리를 흉내 낼 수 있어 회사도 쓸 권리가 있는 목소리만 쓰라고 적었습니다. 사실 정보를 믿을 수 없고 지시를 비서처럼 따르지 않는 연구용 기반 모델이라는 점도 밝혔습니다.
11월 15일 조회 기준 허깅페이스 내려받기는 1,262회, 좋아요는 252개이고 깃허브 별은 359개입니다. higurashi는 매개변수 1,000억 개가 넘는 큰 풀듀플렉스 모델을 이미 학습하고 있고 영상 입력까지 넓힐 계획이라고 했습니다.
앞서 다룬 온디바이스 AI 미라지 글처럼 기기 안에서 도는 작은 모델은 한국어가 뒤로 밀리는 일이 많았습니다. Haru는 처음부터 한국어를 9개 중심 언어에 넣었고 아이폰 통화녹음 글에서 본 서버 중심 통화 AI와 다른 길을 보여 줍니다. 저는 한국어 대화 품질이 검증되는 순간 상담·통역·돌봄 전화처럼 사람 대 사람 통화가 많은 서비스부터 이 방식이 빠르게 들어올 것이라고 봅니다.
참고 논문: 조다영·최준호(2026), 「AI 음성 에이전트의 응답 휴지 시간이 사용자 신뢰와 공감에 미치는 영향」, 한국콘텐츠학회논문지 26(1). · 김동영·정민주·김재은(2025), 「AudioLLM-TTS cascade 인터페이스 표준안: 실시간 음성-음성 아키텍처 구현」, 한국소프트웨어종합학술대회 논문집.
본문 그래프 2점은 higurashi 기술 블로그와 Moshi 논문의 공개 수치로 다대구가 직접 계산·작성했습니다. 대표 이미지는 higurashi가 공개한 Haru-4B 대화 데모 화면입니다.