캑터스 컴퓨트가 11월 6일 공개한 이미지 인식 모델 미라지는 휴대폰에 넣는 파일이 21.6MB입니다. 사진 한 장 크기쯤이죠. 원본 파일을 열어 이 숫자가 어떻게 나왔는지 따라가 보면, 작게 만든 비결보다 무엇을 포기했는지가 더 잘 보입니다.
미라지는 사진을 보고 장면을 설명하고, 물체 위치를 찾고, 글자를 읽고, 물체 영역을 칠하는 일을 모델 하나로 합니다. 서버로 사진을 보내지 않고 기기 안에서 돌아가는 온디바이스 AI입니다. Hugging Face에 올라온 가중치 파일과 설정 파일로 크기와 구조를 다시 확인했습니다.
1. 온디바이스 AI 미라지, 원본 216MB를 10분의 1로 줄였습니다
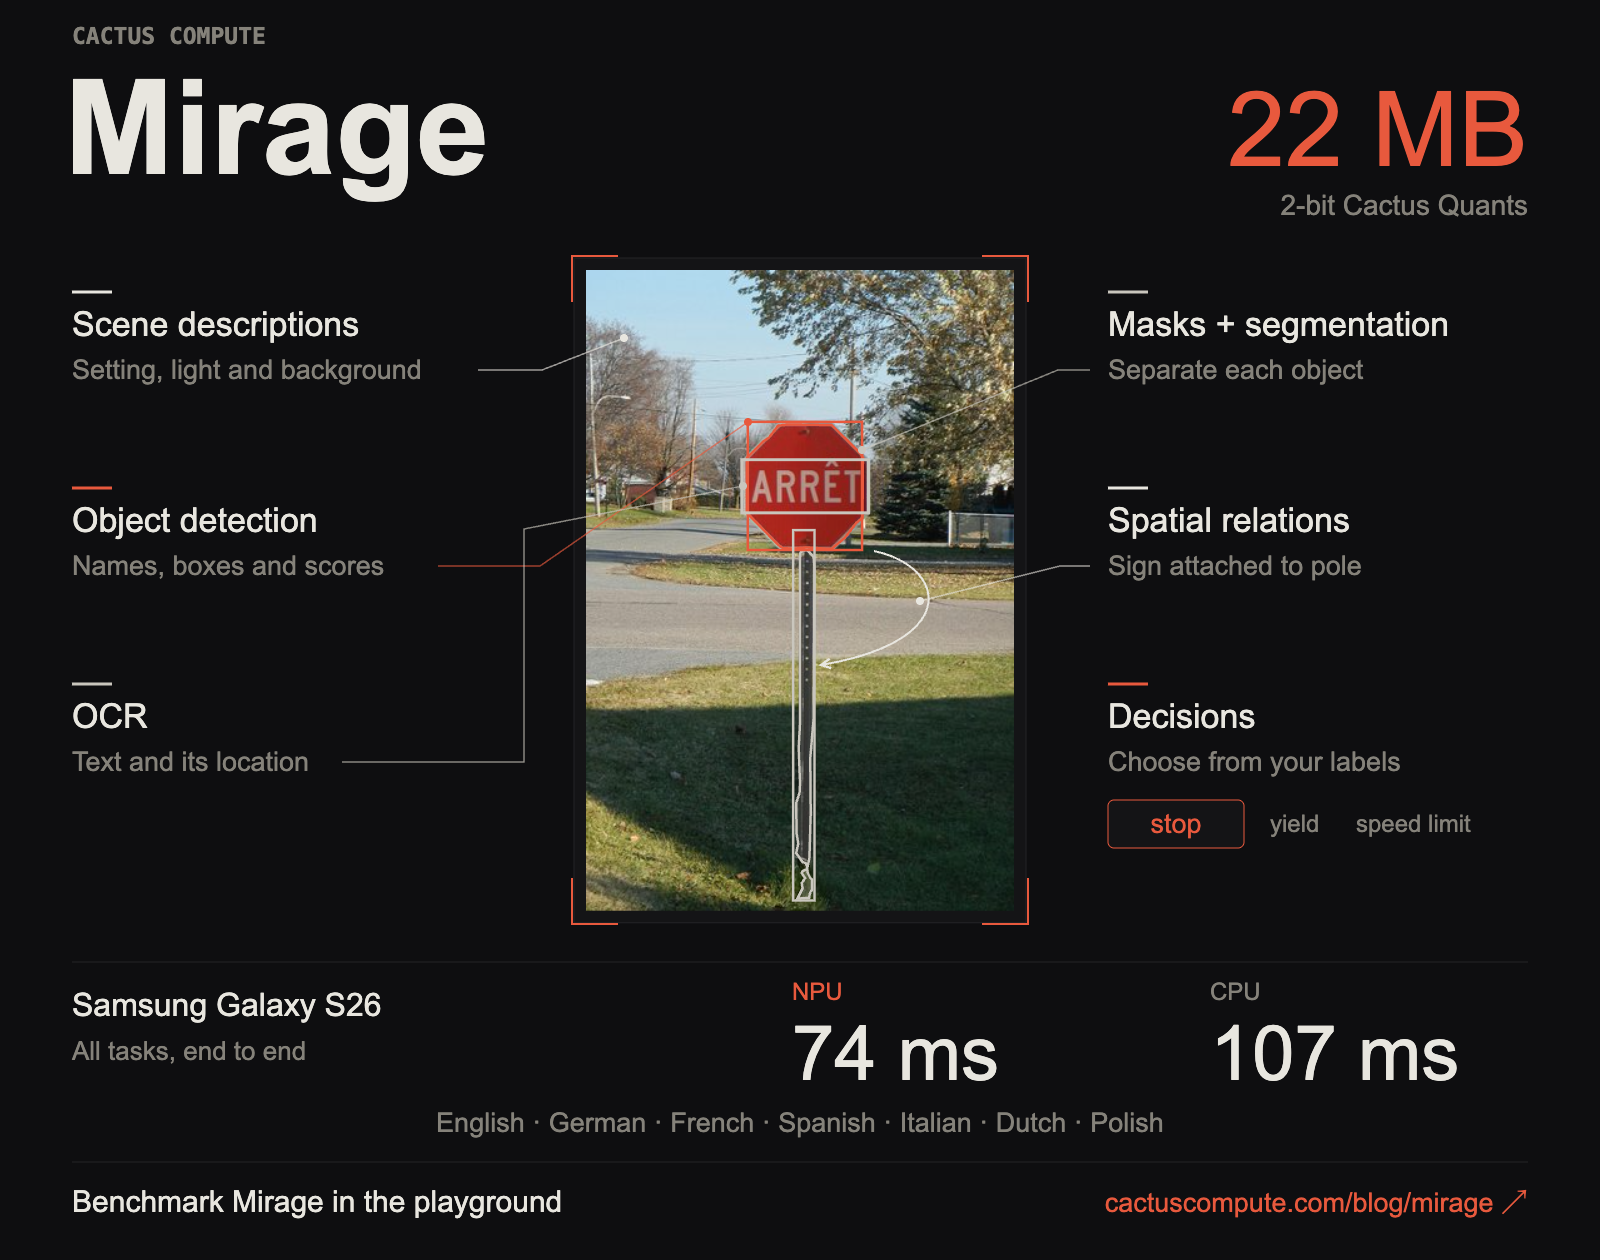
저장소에는 같은 모델이 두 가지 형태로 올라와 있습니다. 32비트 원본 파일은 216.4MB이고, 휴대폰용으로 압축한 파일은 21.6MB입니다. 정확히 10.0배입니다.
방법은 설정 파일에 나옵니다. 행렬 대부분을 2비트로 줄였고, 단어 표와 일부 연결 부분만 4비트로 남겼습니다. 숫자 하나를 32칸이 아니라 2칸에 적는 셈이니, 정밀도를 크게 내준 압축입니다.
발표 수치는 매개변수 5,130만 개입니다. 원본 파일 앞부분의 구조 정보를 받아 텐서 크기를 직접 곱해 보니 5,408만 개가 나왔습니다. 여기서 다음 글자를 미리 맞히는 보조 블록 256만 개를 빼면 5,152만 개로, 발표값과 0.4% 차이입니다. 이 가운데 37%는 자주 나오는 패턴을 찾아 쓰는 조회표가 차지합니다.
2. 비슷한 소형 모델보다 파일은 10~25배 작습니다
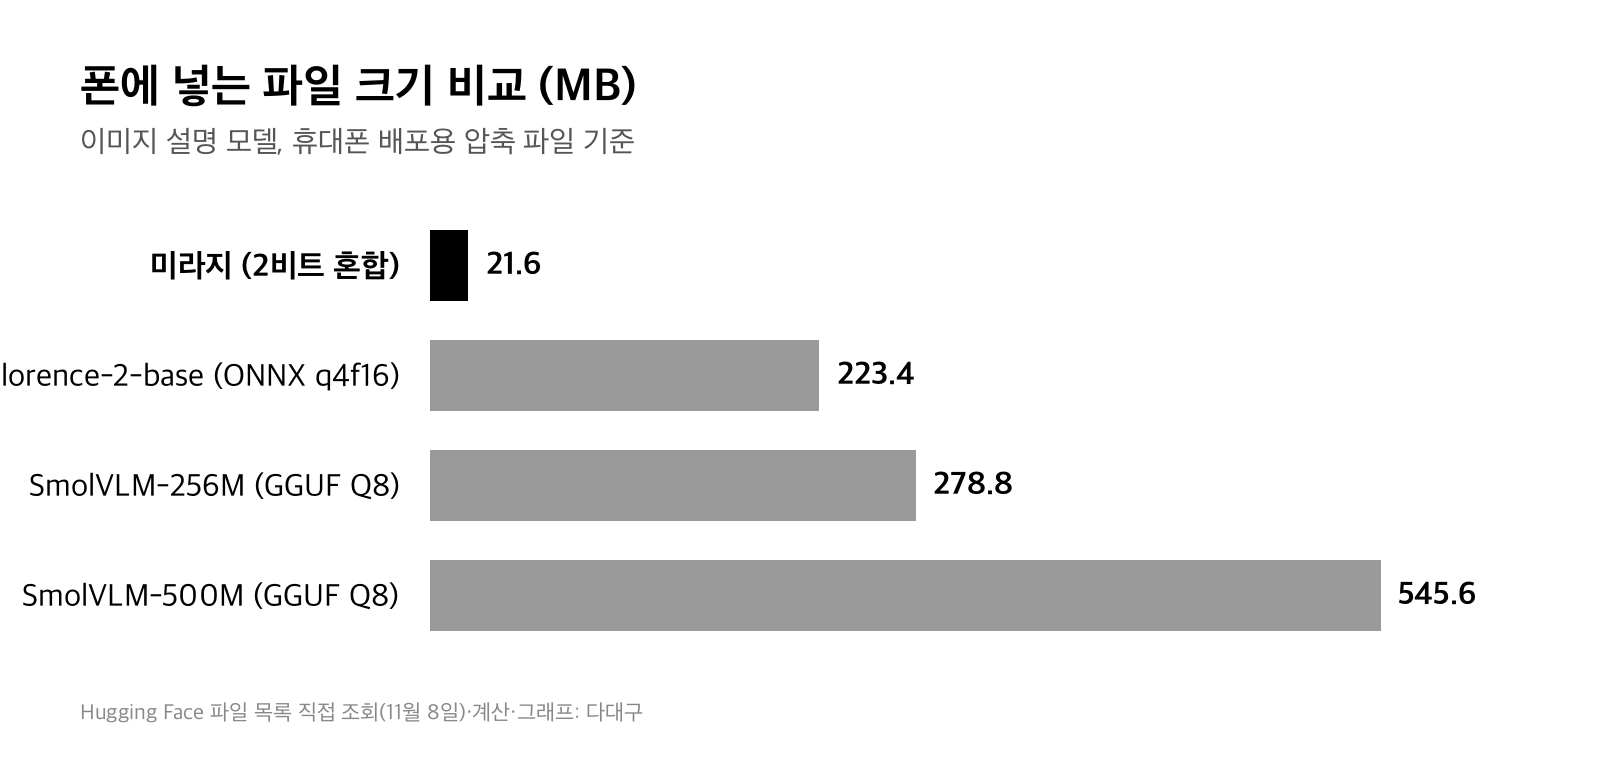
기준을 맞추려고 다른 소형 이미지 모델도 휴대폰용 압축 파일 크기로 비교했습니다. 마이크로소프트 Florence-2-base의 4비트 ONNX 파일은 223.4MB로 미라지의 10.3배이고, 허깅페이스 SmolVLM-256M의 8비트 파일은 278.8MB로 12.9배, SmolVLM-500M은 545.6MB로 25.3배입니다.
매개변수로 보면 차이가 줄어듭니다. SmolVLM-256M은 미라지의 5.0배, Florence-2-base는 4.5배 정도입니다. 미라지가 작은 이유의 절반은 모델 자체가 작아서이고, 나머지 절반은 2비트까지 깎은 압축 덕분입니다.
속도는 회사가 갤럭시 S26에서 잰 값만 있습니다. 신경망처리장치로 74밀리초, 중앙처리장치로 107밀리초였고, 이를 단순히 뒤집어 계산하면 1초에 9~13장입니다. 다른 모델은 같은 기기에서 잰 값이 공개되지 않아 속도 순위는 매길 수 없습니다.
3. 긴 글줄은 겹쳐 읽고 한 번에 합칩니다
문자 인식 쪽 설계는 꽤 꼼꼼합니다. 글줄 높이를 48픽셀로 맞춘 뒤 폭 320픽셀 창으로 읽는데, 창을 224픽셀씩 옮겨서 이웃 창과 96픽셀이 겹치게 합니다. 겹친 부분의 앞뒤 결과는 버리고 남은 결과를 이어 붙여 한 번에 정리합니다.
이렇게 하면 경계에 걸린 글자가 두 번 찍히거나 사라지는 일이 줄어듭니다. 대신 긴 줄일수록 실제 폭보다 약 1.43배를 읽어야 해서 계산량이 늘어납니다. 회사는 이 방식으로 폭 1~10,000픽셀 전부를 검증했다고 밝혔지만, 실제 사진에서 글자를 얼마나 맞히는지는 따로 공개하지 않았습니다.
4. 한국에서 써 볼 만할까
지금은 어렵습니다. 장면 설명이 되는 언어는 영어·독일어·프랑스어·스페인어·이탈리아어·네덜란드어·폴란드어 7개이고 한국어는 없습니다. 한글 간판이나 영수증을 읽히는 용도라면 아직 맞지 않습니다.
성능 수치에도 단서가 있습니다. 회사가 낸 질문 답하기 점수는 100점 만점에 31.3점인데, 미라지가 뽑은 결과를 다른 작은 언어 모델이 읽고 답하는 방식이라 미라지 혼자의 실력으로 보기는 어렵습니다. 파일 크기 21.6MB도 실행할 때 쓰는 메모리와는 다른 숫자입니다.
그래도 개발자에게는 의미가 있습니다. 라이선스가 Apache 2.0이라 상업 앱에 넣을 수 있고, 같은 실행 엔진이 안드로이드·iOS·윈도·브라우저까지 17개 환경을 지원합니다. 저는 미라지가 사진을 이해하는 똑똑한 AI라기보다, 사진에서 물체·위치·글자를 뽑아 다른 프로그램에 넘겨주는 작은 부품에 가깝다고 봅니다.
앞서 다룬 텐센트 Hy4 점수표 분석이 큰 모델의 가격 경쟁을 보여 줬다면, 미라지는 반대쪽 끝에서 벌어지는 경쟁입니다. 아마 내년에는 휴대폰 카메라 앱 안에 이런 수십 MB짜리 부품이 여러 개 들어가는 장면을 흔히 보게 될 겁니다.
본문 그래프 1점은 Hugging Face 저장소 파일 목록을 다대구가 직접 조회해 계산·작성했습니다. 개요 이미지는 Cactus Compute 공식 이미지입니다. 대표 이미지: Cactus Compute 공식 이미지.