온디바이스 AI 회사 Liquid AI가 11월 12일 공개한 음성 코덱 LiquidCodec은 파라미터 7,356만 개짜리 모델로, 애플 M4 Max CPU 한 스레드에서 1분짜리 말을 0.69초 만에 다시 소리로 바꿉니다(다대구 계산). 같은 조건에서 경쟁 코덱 NanoCodec보다 22배, Mimi보다 2.9배 빠릅니다.
그런데 이 코덱으로 학습한 음성 합성 모델의 한국어 받아쓰기 오류율은 8.36%로 비교한 코덱 4개 가운데 3위였습니다. 저는 LiquidCodec이 보여 준 변화가 음질보다 속도에 있다고 봅니다. 휴대폰 안에서 대화하는 음성 AI의 병목이 모델 크기에서 말소리를 바꾸는 단계로 옮겨 가고 있다는 점입니다.
1. 온디바이스 AI 음성 코덱 LiquidCodec, LFM3 오디오 모델에 먼저 들어갔다
음성 코덱은 말소리를 언어 모델이 다룰 수 있는 토큰으로 바꾸고(토크나이저), 모델이 내놓은 토큰을 다시 소리로 되돌리는(디토크나이저) 장치입니다. 음성 AI와 대화할 때 내 말이 들어가고 AI 목소리가 나오는 양 끝에서 매번 돌아가는 부분입니다.
Liquid AI는 2025년 8월 첫 음성 모델 LFM2-Audio-1.5B를 내놓을 때 프랑스 Kyutai의 공개 코덱 Mimi(파라미터 약 9,600만 개)를 그대로 썼습니다. 이후 소리를 되돌리는 쪽만 직접 만들어 바꿨고 이번에는 토크나이저까지 직접 만들었습니다.
새 코덱은 10월 말 공개한 LFM3-Audio-2B와 LFM3-Omni-2B에 먼저 들어갔고 11월 12일 블로그로 구조와 성능이 공개됐습니다. 허깅페이스 기준 LiquidCodec의 파라미터는 7,355만 9,090개로 Mimi의 77% 크기입니다(다대구 계산).
소리는 80밀리초마다 한 번씩 잘라 12개 코드북으로 바꿉니다. 1초에 12.5번 × 12개 = 150개 토큰이 나오는 셈입니다. 남의 코덱을 쓰다가 1년 2개월 만에 자체 코덱으로 바꾼 것은 음성 품질을 남의 설계에 맡기지 않겠다는 선택이라고 봅니다.
2. 음성 AI 대화 속도, 1분 말을 0.69초에 소리로 되돌린다
Liquid AI가 M4 Max 맥북 프로의 CPU 한 스레드, FP32 정밀도로 잰 결과 LiquidCodec은 실시간보다 인코딩 357배, 디코딩 87배 빨랐습니다. 실시간 비율(RTF)이 인코딩 0.0028, 디코딩 0.0115였는데 여기에 60초를 곱하면 1분짜리 말을 토큰으로 바꾸는 데 0.17초, 소리로 되돌리는 데 0.69초가 걸립니다(다대구 계산).
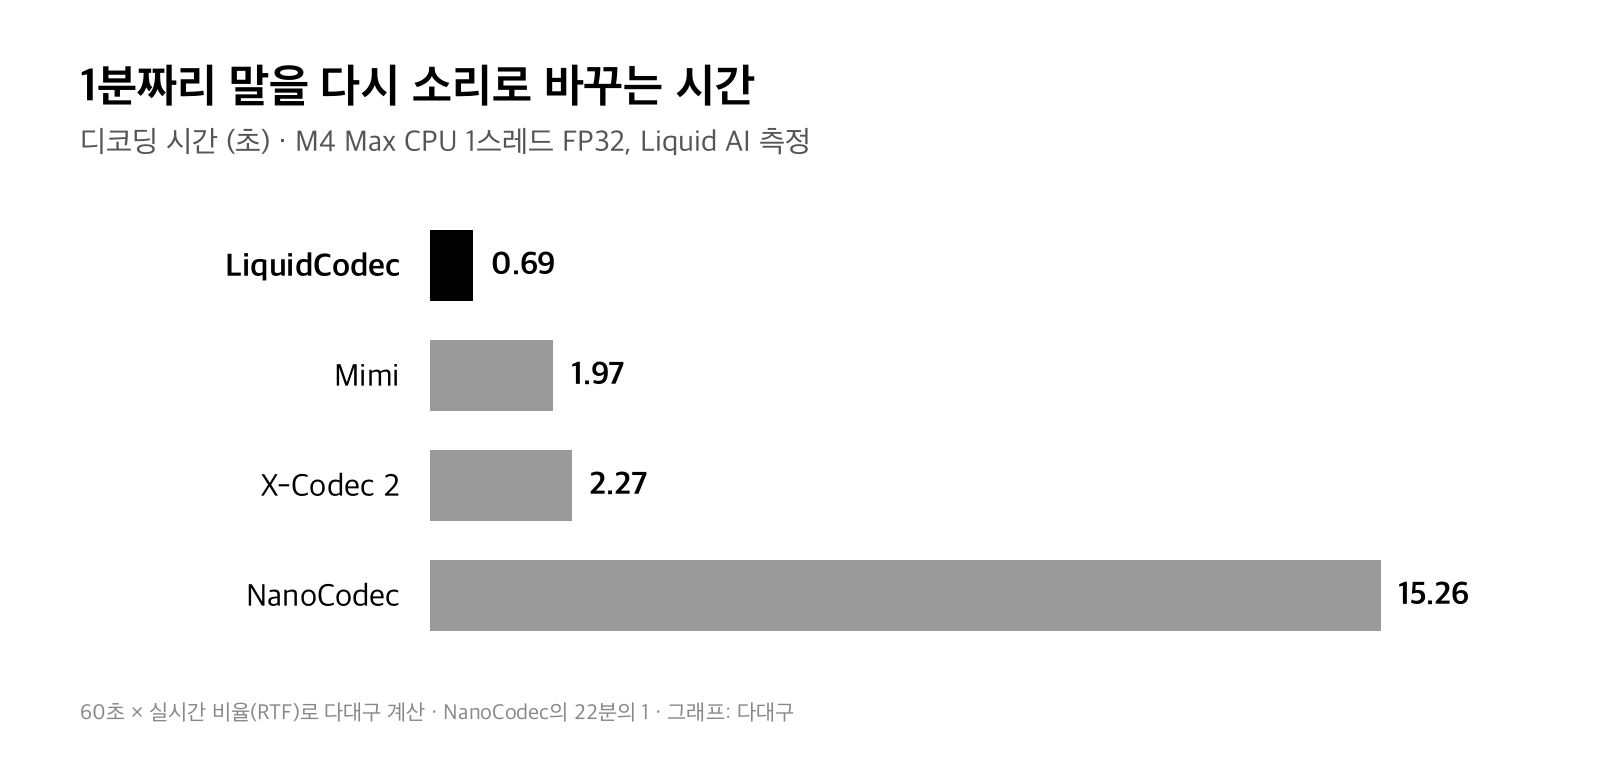
같은 계산으로 경쟁 코덱의 디코딩 시간은 Mimi 1.97초, X-Codec 2 2.27초, NanoCodec 15.26초입니다. 인코딩은 차이가 더 커서 X-Codec 2는 44.15초가 걸려 LiquidCodec의 263배였습니다.
숫자를 읽을 때 걸리는 조건도 있습니다. 모두 Liquid AI가 직접 잰 값이고 코드북 수가 코덱마다 1개에서 13개까지 다릅니다. 그래픽 칩이 아니라 CPU 한 스레드에서 잰 것은 휴대폰 같은 기기 환경에 맞춘 측정이라 경쟁 코덱에 불리할 수 있습니다.
크기도 줄였습니다. 소리를 되돌리는 쪽만 4비트(Q4_0)로 줄이는 양자화 학습을 거쳐 디코더가 차지하는 메모리를 3.5분의 1로 줄였습니다. 국내에서도 유재윤·강창범 연구팀이 2025년 대한전자공학회 하계학술대회에서 음성 인식 모델 Whisper를 1.58비트로 줄여 임베디드 보드에서 크기를 최대 4분의 1, 속도를 2배로 만들고 단어 오류율 저하를 0.3% 안에 묶었다고 보고했습니다.
음성 비서가 대답을 시작하기까지 걸리는 시간을 생각하면 디코딩 0.69초와 15초의 차이는 쓸 수 있는 제품과 못 쓰는 제품의 차이입니다. 저는 이 표가 온디바이스 음성 AI에서 속도 경쟁이 모델 본체 밖으로 넓어졌다는 신호라고 봅니다.
3. 학습 데이터 26만 4,000시간·107개 언어, 깨끗한 음성은 20.8%
LiquidCodec은 두 단계로 학습했습니다. 1단계는 웹 음성·오디오북·크라우드 녹음·의회와 회의 녹음을 섞은 107개 언어 26만 4,000시간, 2단계는 24kHz 이상으로 녹음된 깨끗한 음성 5만 5,000시간입니다. 2단계 데이터는 1단계의 20.8%입니다(다대구 계산).
Liquid AI는 1단계에서 흔히 쓰는 적대적 학습(GAN)을 일부러 뺐다고 밝혔습니다. 그 결과 쇳소리 같은 잡음이 남았고 2단계에서 파형·스펙트럼·음성 특징을 따로 보는 판별 모델을 더해 이 잡음을 줄였습니다. 실패한 단계를 감추지 않고 적은 점은 이 발표에서 믿을 만한 대목입니다.
비교 방식도 적어 두었습니다. 코덱 4개마다 같은 6개 언어 10만 1,000시간 데이터, 같은 음성 합성 구조, 같은 연산 예산으로 음성 합성 모델을 따로 학습시켜 비교했고 바탕 모델을 Liquid의 LFM3-1.7B에서 알리바바의 Qwen3-1.7B로 바꿔도 결과가 비슷했다고 했습니다.
자사 모델에만 유리한 비교를 피하려 한 흔적은 보이지만 시험 데이터 8개와 음성 합성 3회 평균은 모두 회사 안에서 돌린 값입니다. 독립 평가가 나오기 전까지는 속도 쪽 숫자를 품질 쪽 숫자보다 더 믿는 편이 맞다고 봅니다.
4. 한국어 음성 합성은 4개 코덱 중 3위, 4비트가 원본보다 나았다
FLEURS 한국어 시험에서 LiquidCodec은 소리 복원 지표 6개 가운데 5개(SQMOS·PESQ·멜 거리·화자 유사도·ViSQOL)에서 1위였습니다. 원래 소리를 토큰으로 바꿨다가 되돌리는 일은 한국어에서도 가장 잘했습니다.
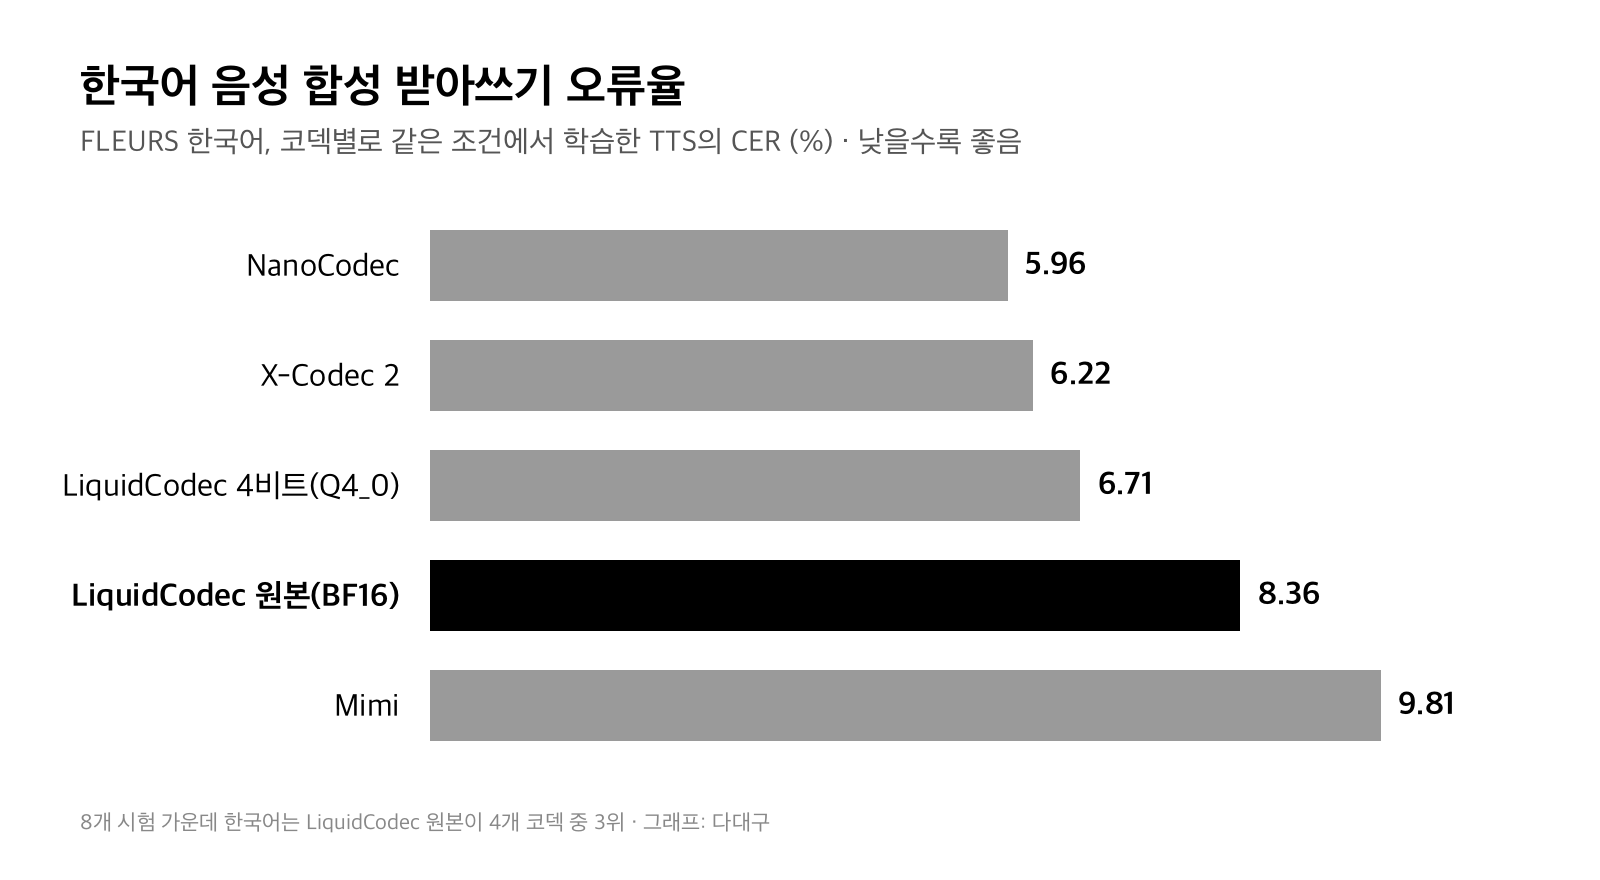
그런데 이 코덱의 토큰으로 학습한 음성 합성 모델이 만든 한국어를 받아 적었을 때 오류율은 8.36%였습니다. NanoCodec 5.96%, X-Codec 2 6.22%보다 높고 Mimi 9.81%보다만 낮아 4개 가운데 3위입니다. NanoCodec보다 오류가 1.4배 많습니다(다대구 계산).
Liquid AI는 8개 시험 가운데 4개에서 받아쓰기 오류율이 가장 낮았다고 했는데 한국어·일본어·중국어 FLEURS는 그 4개에 들지 않았습니다. 같은 코덱을 4비트로 줄인 쪽이 6.71%로 원본보다 낮게 나온 것도 이상한 점입니다. 3회 생성 평균이라 한국어 점수에는 우연의 몫이 크다고 보는 편이 자연스럽습니다.
한국어 음성 데이터가 적다는 점은 국내 연구에서도 반복해 나옵니다. 이호준·석종원 연구팀이 2026년 아시아태평양융합연구교류논문지에 낸 경량 다국어 음성 합성 연구는 한국어를 포함한 언어당 30~45분 데이터로 학습해 평균 의견 점수 4.21, 단어 오류율 16.6%를 얻었습니다.
소리는 가장 잘 되살리지만 받아 적기 쉬운 한국어 말을 만드는 데는 아직 3위입니다. 한국어 음성 비서에 바로 넣기보다 한국어 데이터로 다시 맞춰 볼 코덱이라고 봅니다.
5. 온디바이스 AI로 써 보려면, LFM 1.0 라이선스와 다운로드 2만 2,337회
LiquidCodec은 허깅페이스에서 내려받아 Transformers 라이브러리로 바로 불러올 수 있고 LFM3-Audio-2B와 LFM3-Omni-2B의 GGUF 파일에는 llama.cpp용 Q4_0·Q4_K_M·Q8_0 양자화 버전이 들어 있습니다. 라이선스는 Liquid AI 자체 라이선스인 LFM 1.0이라 상업적으로 쓰려면 조건을 먼저 읽어야 합니다.
11월 15일 조회 기준 LiquidCodec 누적 다운로드는 2만 2,337회이고 최근 30일이 9,714회로 43.5%입니다. 10월 21일 올라온 LFM3-Omni-2B는 한 달이 안 돼 2만 1,030회를 기록했습니다(다대구 계산).
앞서 다룬 온디바이스 AI 미라지 글에서도 22MB 이미지 인식 모델이 작고 빨랐지만 한국어는 빠져 있었습니다. 기기 안에서 도는 작은 모델은 영어와 중국어에서 먼저 완성되고 한국어는 나중에 따라오는 흐름이 이번에도 반복됐습니다.
휴대폰 통화에서 음성 AI를 쓰는 방식은 아이폰 통화녹음 글에서 정리한 에이닷·익시오처럼 지금은 대부분 서버를 거칩니다. 저는 1분 말을 1초 안에 되돌리는 코덱이 공개된 이상 통화·번역·음성 비서가 기기 안으로 들어오는 속도는 빨라지고 한국어 품질을 누가 먼저 채우느냐가 다음 경쟁이 될 것이라고 봅니다.
참고 논문: 유재윤·강창범(2025), 「1.58 Bit quantized Whisper」, 대한전자공학회 학술대회. · 이호준·석종원(2026), 「IPA & PL-BERT 기반 경량 다국어 StyleTTS 2」, 아시아태평양융합연구교류논문지 12(3).
본문 그래프 2점은 Liquid AI가 공개한 LiquidCodec 측정표로 다대구가 직접 계산·작성했습니다. 대표 이미지는 다대구 생성 이미지입니다.