퍼플렉시티 AI가 11월 12일 판단·정보 추출 전용 모델 Decider v1.3(270억 파라미터급)과 Decider Flash v1.3(40억 파라미터급)을 Apache-2.0 오픈소스로 공개했습니다. 회사가 내건 대표 숫자는 사내 질의 분류 63개 과제 평균 정확도 91.63%입니다. 지금 퍼플렉시티가 실제로 쓰는 분류기(85.09%)보다 6.54%포인트 높다는 것입니다.
그런데 같은 표에 있는 경쟁 판단 모델 Jev 1.14의 점수는 91.42%입니다. 6.54%포인트 가운데 경쟁 모델과 벌어진 폭은 0.21%포인트뿐입니다. 이번 판에서 숫자가 크게 달라진 곳은 분류보다 새로 넣은 문서 추출 기능 locate 쪽입니다.
공식 블로그와 차트 9장, Hugging Face 모델 카드, OpenRouter 모델 목록, 퍼플렉시티 개발 문서를 놓고 점수·가격·무료 기간을 다시 계산했습니다. 기준 시각은 11월 15일 오전(한국 시각)입니다.
1. 퍼플렉시티 AI 모델 Decider는 문장 대신 선택지 확률로 답하는 판단 모델입니다
Decider는 입력을 받아 정해진 선택지 가운데 어느 쪽인지 확률로 돌려주는 판단 모델입니다. “이 질문에 웹 검색이 필요한가”, “이 리뷰는 불만인가” 같은 물음에 예·아니오나 점수로 답합니다. 퍼플렉시티는 이런 판단을 사용자 질의마다 여러 개씩 돌립니다.
v1.3은 알리바바의 Qwen3.8-27B를, Flash v1.3은 Qwen3.5-4B를 바탕으로 다시 학습했습니다. Hugging Face에 올라온 파라미터 수는 각각 260억 8,533만 개와 45억 3,927만 개이고, 내려받는 파일은 약 54.1GB와 9.6GB입니다. 블로그는 TypeSafe AI의 판단 모델 Jev에서 아이디어를 얻었다고 직접 밝혔습니다.
버전을 올리는 속도도 빠릅니다. Hugging Face 기록으로 v1은 10월 1일, v1.1은 10월 5일, v1.2와 Flash v1.2는 10월 15일, v1.3은 11월 12일에 나왔습니다.
첫 판부터 이번 판까지 42일 동안 네 번 바뀌었고, 간격은 4일·10일·28일이었습니다(다대구 계산). 저는 이 속도를 보면 퍼플렉시티가 Decider를 자기 검색 서비스의 부품으로 계속 고쳐 쓰고 있다고 봅니다.
2. 정확도 6.54%포인트는 자사 분류기와 비교한 값이고, 경쟁 모델과는 0.21%포인트 차이입니다
퍼플렉시티 블로그의 6.54%포인트는 Decider v1.3의 91.63%에서 자사 운영 분류기의 85.09%를 뺀 값입니다. 비교 상대는 임베딩 모델 위에 분류 헤드를 여러 개 얹은 퍼플렉시티 내부 시스템입니다. 그 크기나 학습 시점은 공개하지 않았습니다.
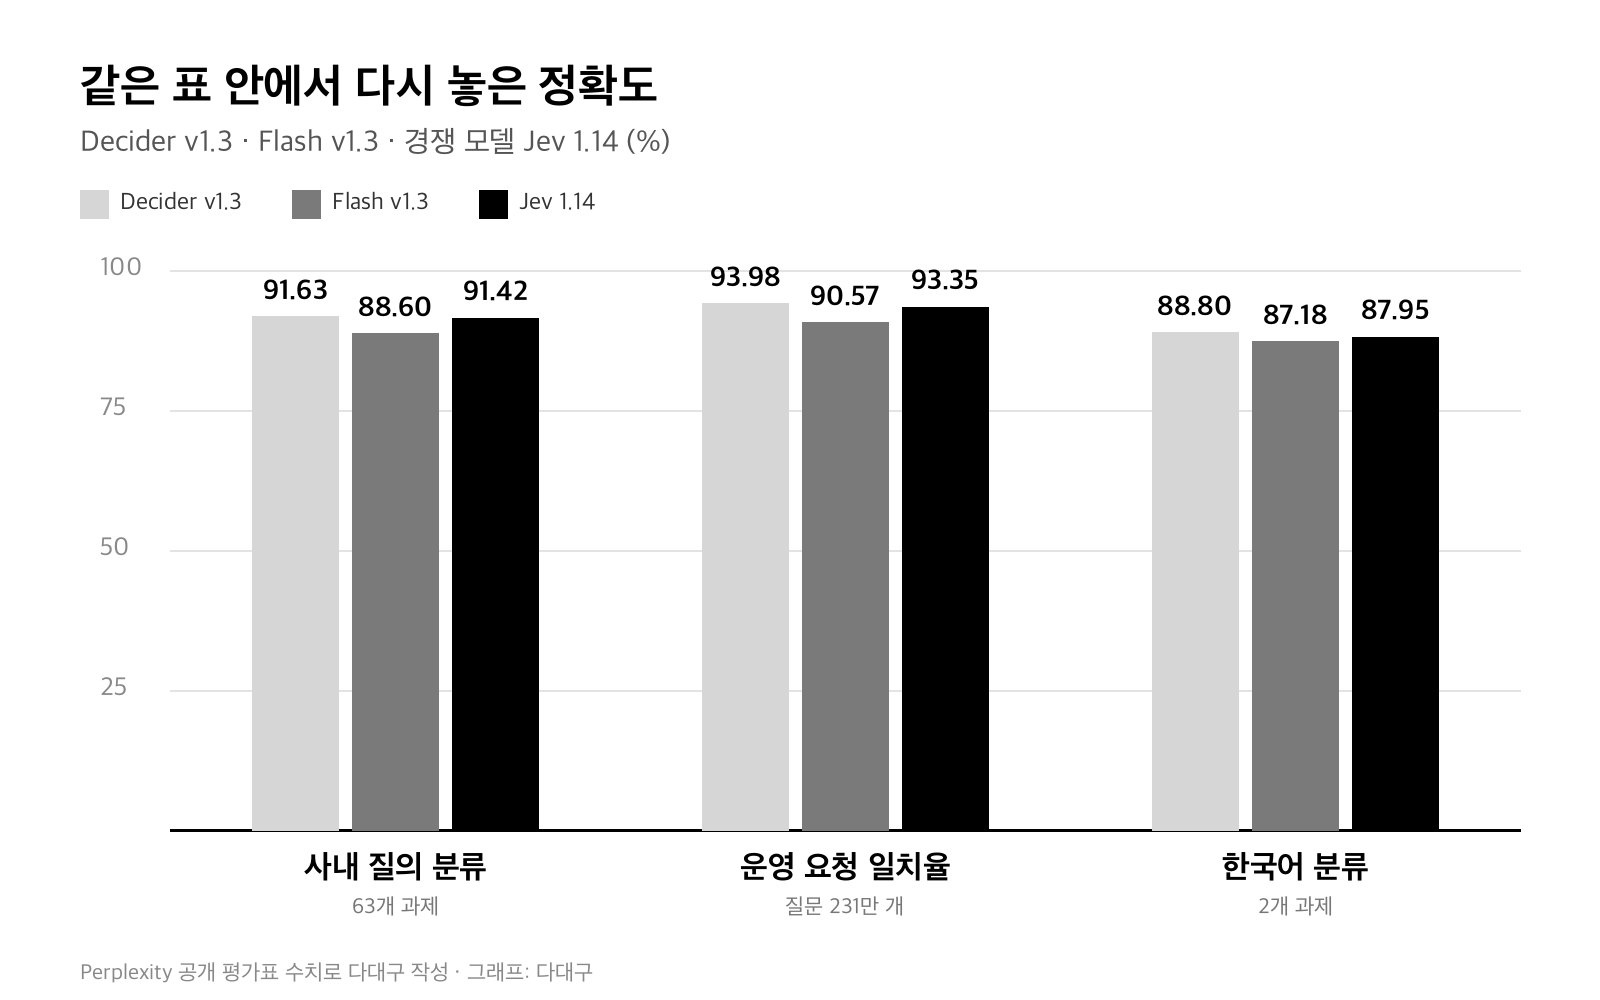
같은 표를 다시 놓으면 그림이 달라집니다. Jev 1.14는 91.42%로 v1.3과 0.21%포인트 차이입니다. 6.54를 0.21로 나누면 자사 분류기와의 격차가 경쟁 모델과의 격차보다 약 31배 큽니다(다대구 계산).
출시 첫 18일 동안 받은 실제 요청 질문 231만 8,887개에서도 v1.3의 일치율은 93.98%, Jev는 93.35%였습니다. 차이는 0.63%포인트입니다.
정답을 누가 매겼는지도 봐야 합니다. 63개 과제의 정답은 이름을 밝히지 않은 최신 대형 언어모델이 다시 매긴 라벨이고, 운영 요청 평가는 정답 없이 그 심판 모델과 답이 얼마나 같은지를 잰 일치율입니다.
이전 판보다 낮아진 곳도 있습니다. 사내 질의 분류 전체는 v1.2보다 0.25%포인트, 검색 결과 재순위 전체는 0.39%포인트 내려갔습니다.
v1.3이 확실히 앞선 곳은 답의 안정성입니다. 같은 질문을 선택지 순서만 바꿔 다시 물었을 때 답이 뒤집힌 비율은 v1.3이 372문항 중 1문항(0.27%), Jev가 17문항(4.57%)이었습니다.
문항 수가 적어 크게 일반화하기는 어렵지만, 같은 입력에 같은 답을 내는 힘은 분명히 나아졌습니다. 저는 이번 판의 분류 성능은 경쟁 모델과 비긴 수준이고, 내세울 만한 차이는 정확도보다 답의 안정성에 있다고 봅니다.
3. 새 기능 locate는 문서 추출 평균 69.03점으로 Liquid d1의 1.6배입니다
locate는 문서에서 원하는 정보를 원문 그대로 잘라 내고 그 글자의 시작·끝 위치까지 함께 돌려주는 추출 기능입니다. 퍼플렉시티 개발 문서의 예시에서 “The AeroPress arrived with a cracked filter cap.”로 시작하는 리뷰를 넣고 제품 이름을 물으면, 모델은 AeroPress라는 글자와 위치 4~13, 확신 점수 0.9999를 함께 내놓습니다.
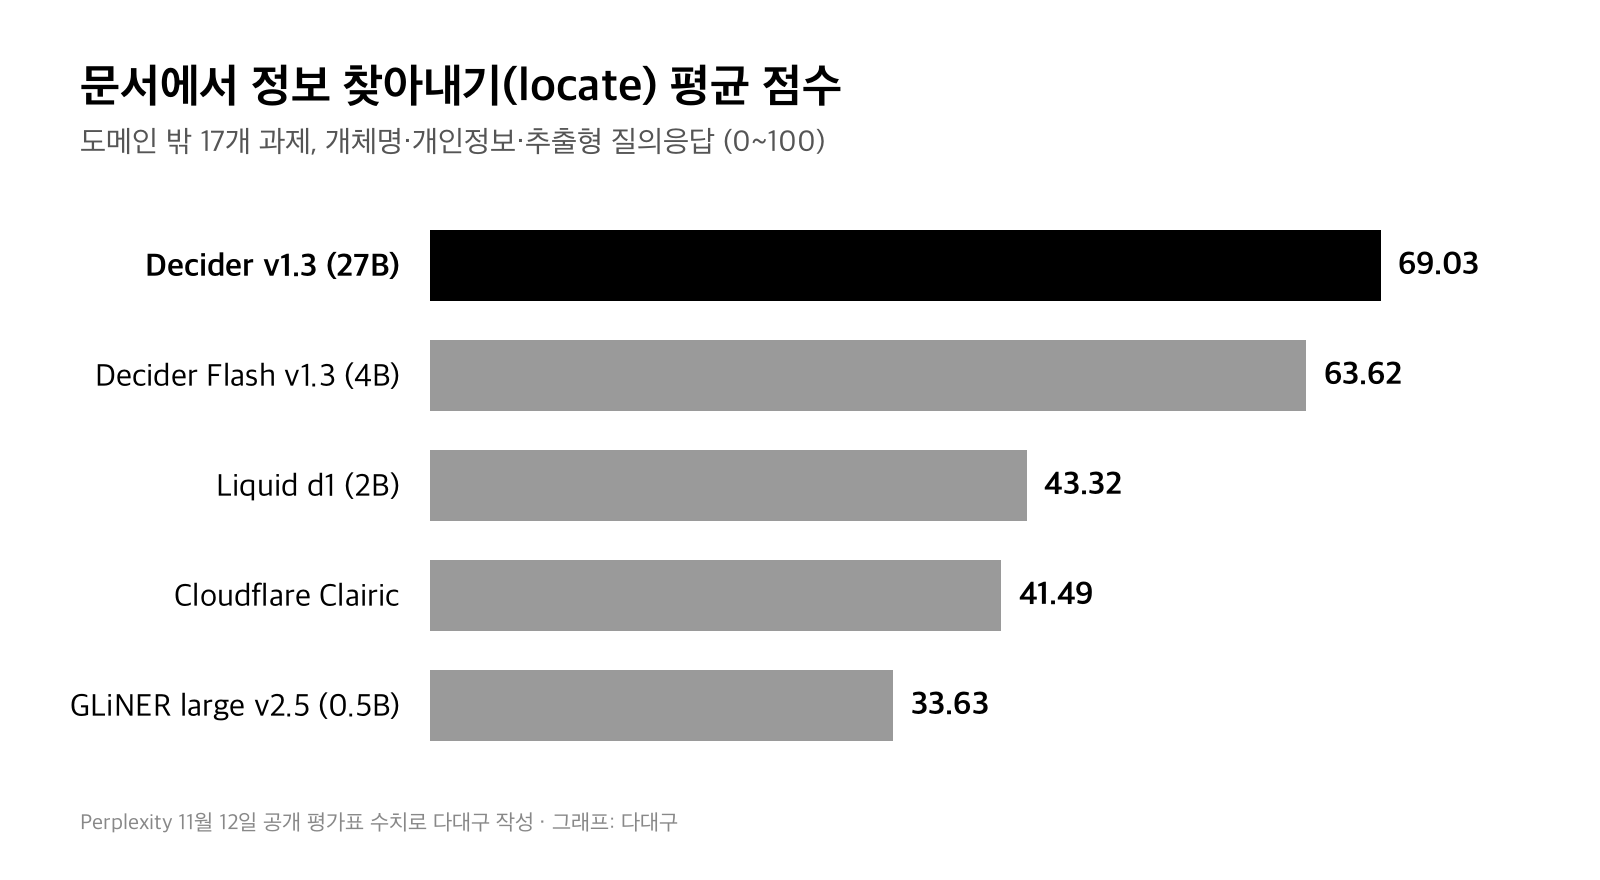
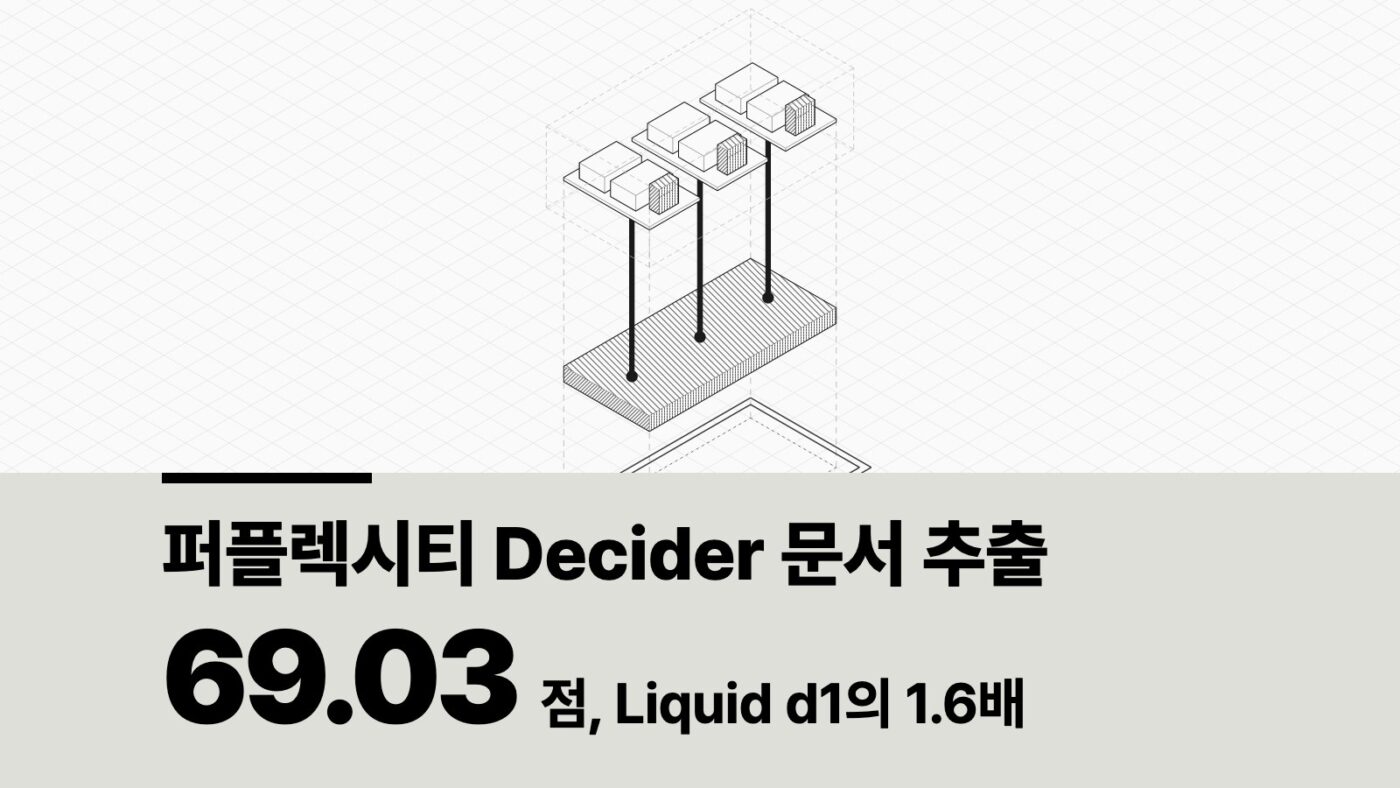
개체명·개인정보·추출형 질의응답 17개 과제 평균에서 v1.3은 69.03점, Flash v1.3은 63.62점이었습니다. 비교 대상인 Liquid d1은 43.32점, Cloudflare Clairic은 41.49점, GLiNER large v2.5는 33.63점입니다.
69.03을 43.32로 나누면 1.6배입니다. 개인정보 찾기 3개 과제만 보면 77.42점 대 44.29점으로 격차가 더 큽니다(다대구 계산).
다만 덩치가 다릅니다. Liquid d1은 20억, GLiNER는 5억 파라미터이고 Decider v1.3은 그보다 13~54배 큽니다. 크기를 맞춘 비교에 가까운 쪽은 Flash v1.3(40억)과 Liquid d1(20억)인데, 2배 큰 모델이 점수는 1.47배 높았습니다.
큰 모델이 더 잘하는 것은 당연하다는 반론이 나올 수 있지만, 저는 반대로 생각합니다. 같은 무료 조건에서 쓸 수 있는 추출 모델 가운데 개인정보를 70점대로 찾는 모델은 이 표에서 Decider 두 개뿐이기 때문입니다.
한계는 블로그가 스스로 적었습니다. locate는 별도의 작은 부품(LoRA 어댑터)으로 학습했는데, 이것을 본체에 합치면 분류 성능이 떨어져서 지금은 추출 요청 때만 켭니다.
그래서 분류와 추출을 한 요청에 섞으면 따로 계산하는 만큼 응답이 느려지고, 이미지 입력에서는 locate를 쓸 수 없습니다. 저는 locate가 이번 판의 진짜 신제품이지만 아직 본체와 한 몸이 되지 못한 단계라고 봅니다.
4. 퍼플렉시티 AI 무료 사용은 OpenRouter에서 11월 19일까지, 그 뒤 계약서 1만 건은 4달러 안팎입니다
11월 15일 OpenRouter 모델 목록에서 Decider v1.3과 Flash v1.3은 입력·출력 모두 0달러인 무료 모델로 올라와 있습니다. 11월 19일까지라는 기한은 OpenRouter 최고경영자 알렉스 아탈라가 11월 13일 X에 올린 글이 근거입니다.
퍼플렉시티 최고경영자 아라빈드 스리니바스는 “일주일 동안 무료”라고만 썼습니다. OpenRouter API의 종료일 칸은 비어 있어서, 기한이 시간대에 따라 하루 달라질 수 있습니다.
무료 기간이 끝난 뒤에는 퍼플렉시티 자체 Decisions API 기준으로 입력 100만 토큰당 v1.3이 0.02달러, Flash가 0.01달러이고 출력은 받지 않습니다. 계약서 한 건을 2만 토큰으로 잡고 1만 건을 처리하면 입력은 2억 토큰입니다.
200 × 0.02달러 = 4달러, Flash는 2달러입니다. 같은 양을 OpenRouter의 Jev 1.14(100만 토큰당 0.042달러)로 돌리면 8.4달러입니다(다대구 계산). 웹 검색으로 근거를 찾게 하면 1건에 0.001달러가 더 듭니다.
블로그의 100만 요청 비용 차트(v1.3 26.47달러, Jev 68.10달러)는 그대로 믿기 어렵습니다. Decider는 자기 장비에서 돌린 값이고 Jev는 OpenRouter 요금이라 조건이 다르다고 블로그가 직접 밝혔습니다. 위 계산처럼 공개 요금표끼리 놓으면 차이는 약 2.1배입니다.
긴 문서에는 숫자 하나를 더 봐야 합니다. OpenRouter와 개발 문서는 한 번에 26만 2,144토큰을 넣을 수 있다고 적었지만, 모델 카드는 학습을 3만 720토큰까지만 했다고 밝힙니다.
내건 길이가 학습 길이의 8.5배인 만큼, 수십 쪽짜리 계약서를 통째로 넣기 전에 자기 문서로 결과를 확인하라는 카드의 주의는 과장이 아닙니다. 저는 무료 기간인 지금이 가격보다 이 길이 문제를 시험해 볼 때라고 봅니다.
5. 한국어 문서에 써 볼 만할까, 한국어 분류 과제는 2개뿐입니다
퍼플렉시티가 공개한 8개 언어 분류 평가에서 한국어 점수는 v1.3이 88.80%, Flash가 87.18%, Jev가 87.95%였습니다. v1.3은 Jev보다 0.85%포인트 높고 Flash는 0.77%포인트 낮습니다.
한국어 과제가 2개뿐이라 이 차이로 한국어 성능을 판단하기는 어렵습니다. locate 평가 17개 과제에는 언어별 점수가 없습니다.
한국어 정보 추출은 학습 데이터부터 부족한 분야입니다. 정영상·지승현·권다롱새 연구팀이 2023년 정보처리학회논문지에 낸 연구에서는 생성형 대형 언어모델로 한국어 정보 추출 학습 데이터를 만들었더니, 관계 추출 과제에서 KLUE-RoBERTa-large보다 25.47% 높은 성능이 나왔습니다.
데이터를 어떻게 만드느냐에 따라 성능이 크게 바뀐다는 결과입니다. Decider 카드도 성능 향상의 큰 몫이 tasksource 공개 데이터 덕분이라고 적었습니다.
그래서 한국어 계약서·민원 문서에 쓰려는 개발자라면 무료 기간 안에 자기 문서 100건 정도로 locate 결과를 직접 맞춰 보는 것이 순서입니다. 모델 카드는 확률을 그대로 쓰지 말고 자기 데이터로 기준값을 다시 맞추라고 권하고, v1.2에서 정한 기준값도 v1.3에서 다시 확인하라고 적었습니다.
내 컴퓨터에서 직접 돌리려면 v1.3은 가중치만 약 49GiB라 80GB급 GPU가 필요하고, Flash는 약 8.5GiB입니다.
앞서 다룬 잉클링 2 스몰 글에서 같은 작업량의 비용을 모델끼리 비교했고, 얀 르쿤 작은 모델 글에서는 작은 모델이 큰 모델을 앞서는 폭을 계산했습니다. 이번 Decider는 비용과 크기라는 두 질문을 한 번에 던집니다.
다음 날짜는 무료 기간이 끝나는 11월 19일, 비교 대상 Liquid d1이 OpenRouter에서 내려가는 11월 20일입니다. 저는 판단 모델 시장의 경쟁이 정확도 0.2%포인트 싸움에서 추출 기능과 답의 안정성, 100만 토큰당 몇 센트의 가격 싸움으로 옮겨 가고 있다고 봅니다.
참고 논문: 정영상·지승현·권다롱새(2023), 「생성형 대규모 언어 모델과 프롬프트 엔지니어링을 통한 한국어 텍스트 기반 정보 추출 데이터셋 구축 방법」, 정보처리학회논문지. 소프트웨어 및 데이터 공학 12(11).
본문 그래프 2점은 퍼플렉시티 공식 블로그 평가표 수치로 다대구가 직접 작성했습니다. 대표 이미지는 Perplexity 공식 블로그 그림에 다대구가 글자를 더했습니다.