1억 900만 파라미터 모델이 720억 파라미터 LLM을 앞섰다는 얀 르쿤 연구, 논문 표를 시험별로 다시 나눠 보면 앞선 폭은 9%에서 49%까지 벌어집니다. 네 번 돌린 실행 가운데 한 번은 30억짜리 모델보다도 낮았습니다.
얀 르쿤과 랜들 발레스테리에로가 10월 29일 arXiv에 올린 논문의 대표 숫자는 0.184입니다. 1억 900만 파라미터 텍스트 모델이 이미지 모델 DINOv2와 얼마나 잘 맞는지 잰 점수인데요. 같은 시험에서 Qwen2.5 720억 모델은 0.154였습니다.
파라미터는 약 660배 차이가 납니다(다대구 계산). 그런데 이 0.184는 세 번 돌린 결과의 평균이고, 네 번째 실행은 0.121에 그쳤습니다.
다대구가 논문 표와 공식 저장소 숫자를 같은 기준으로 다시 정리했습니다. 해커뉴스에 달린 댓글 85개도 함께 읽었습니다.
1. 이긴 시험은 ‘사진 모델과 생각 지도가 얼마나 겹치나’였습니다
이 연구는 글쓰기나 코딩 실력을 재지 않았습니다. 사진만 보고 배운 모델과 글만 읽고 배운 모델이 세상을 비슷한 모양으로 정리하는지를 봤습니다.
예를 들어 강아지 사진 두 장이 사진 모델 안에서 가깝게 놓이면, 그 사진을 설명한 문장 두 개도 텍스트 모델 안에서 가깝게 놓이는지 확인합니다. 시험 자료 WIT-1024의 사진·설명 1,024쌍에서 서로의 가까운 이웃 10개가 얼마나 겹치는지 센 값이 0.184입니다.
이 생각의 뿌리는 2024년에 나온 ‘플라톤 표현 가설’입니다. 큰 모델일수록 어떤 자료로 배우든 같은 세계 모형에 가까워진다는 주장인데요. 르쿤 팀은 여기에 “크기보다 무엇을 짝지어 배우느냐가 먼저”라는 답을 내놓았습니다.
2. 앞선 폭을 시험마다 다시 계산하면 9%에서 49%까지입니다
같은 1억 900만 모델의 점수는 논문과 저장소에 시험별로 나와 있습니다. 이를 Qwen2.5 720억 모델 점수로 나눠 앞선 폭을 계산했습니다.
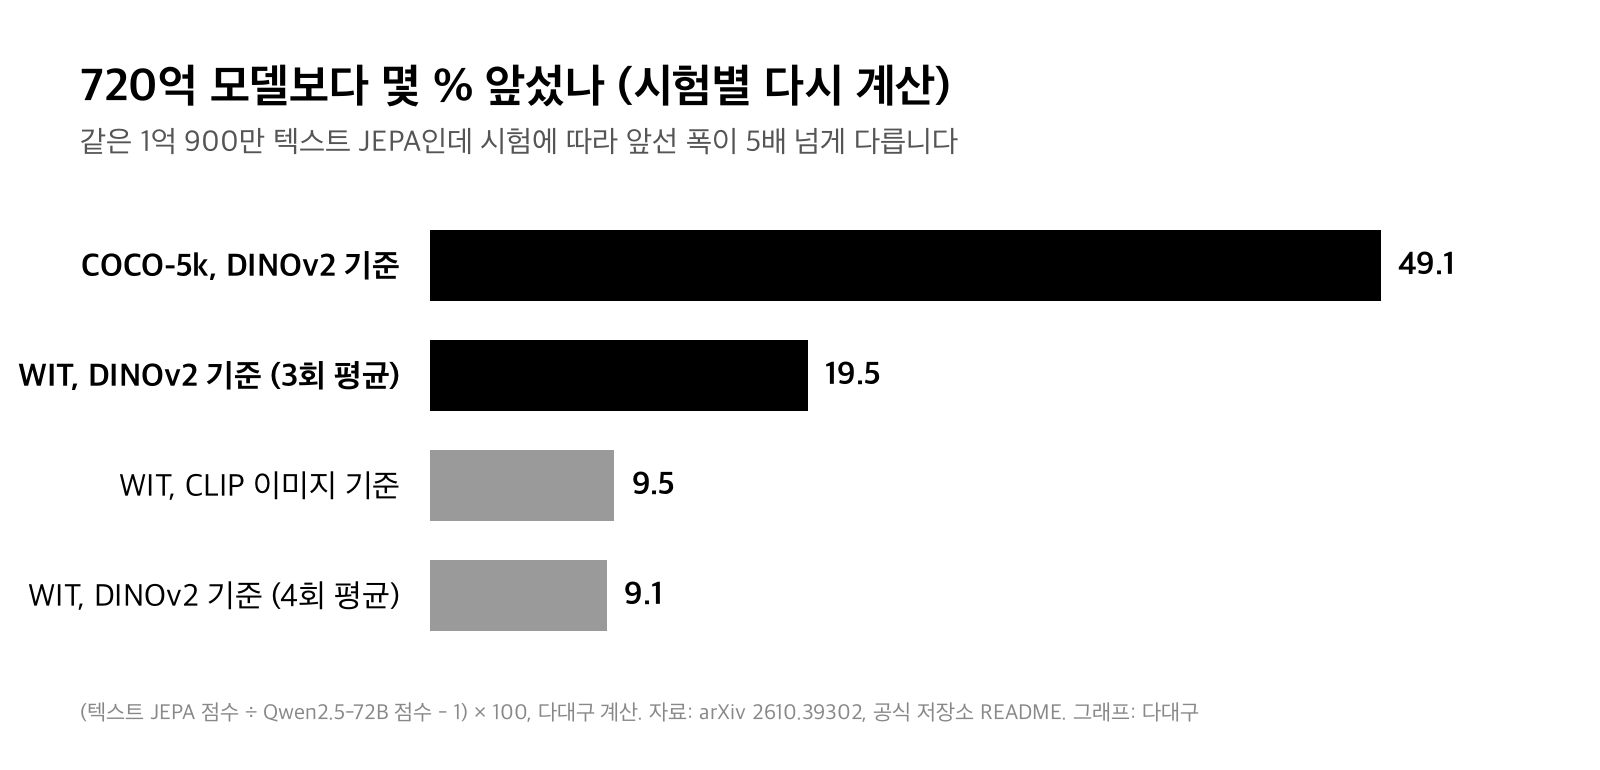
COCO 사진 5,000장 시험에서는 0.161 대 0.108로 49.1% 앞섰습니다. 대표 시험인 WIT에서 DINOv2 기준으로는 19.5%, CLIP 이미지 모델 기준으로는 9.5%였습니다(다대구 계산).
네 번째 실행까지 넣으면 그림이 또 달라집니다. 정규화 가중치를 두 배로 둔 이 실행은 0.121이었고, 네 번 평균은 0.168로 앞선 폭이 9.1%로 줄어듭니다.
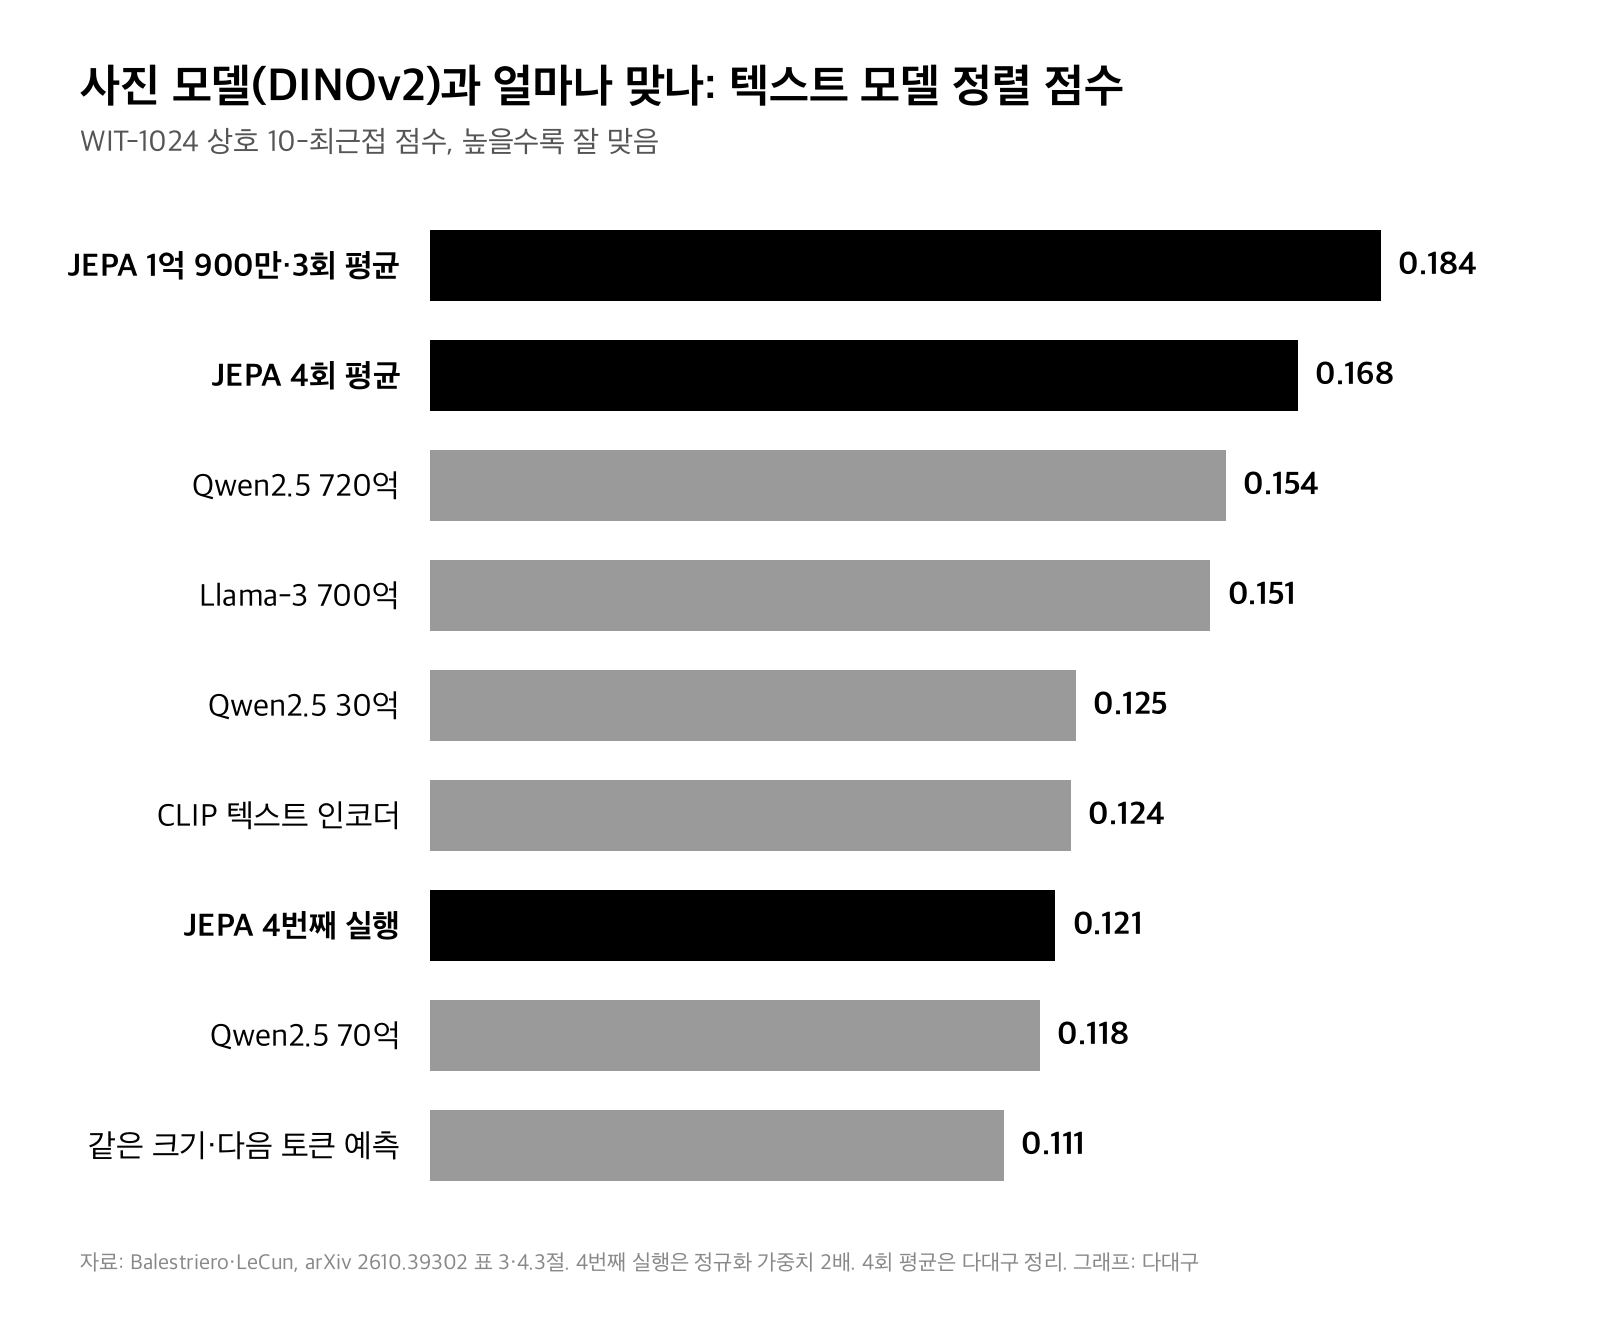
0.121은 Qwen2.5 30억 모델(0.125)과 CLIP 텍스트 인코더(0.124)보다 낮은 숫자입니다. 설정 하나를 바꾸자 720억 모델을 앞서던 결과가 30억 모델 아래로 내려간 셈입니다.
저자들은 이 결과를 본문에 그대로 적었습니다. 그래도 저는 “작은 모델이 대형 LLM을 이겼다”는 제목보다 “잘 맞춘 설정에서 9~49% 앞섰다”는 쪽이 이 논문을 더 정확하게 전한다고 봅니다.
3. 크기 대신 바꾼 건 ‘같은 장면을 쓴 두 문장’이었습니다
JEPA는 정답 단어를 맞히는 대신, 두 입력이 같은 대상을 가리키는지 생각 공간에서 맞추며 배우는 방식입니다. 이번 텍스트 JEPA는 같은 사진을 설명한 서로 다른 문장 두 개를 짝으로 썼습니다.
저자들은 이런 짝을 ‘좋은 관측’이라고 불렀습니다. 반대로 한 문서의 앞부분으로 뒷부분을 맞히는 다음 토큰 예측은 한 관측을 쪼갠 ‘나쁜 관측’이라고 봤는데요. 지금의 챗GPT류 LLM이 학습하는 방식이 바로 이쪽입니다.
효율 차이는 큽니다. 좋은 관측 2,160만 개로 배운 모델이, 같은 크기에 다음 토큰 예측으로 9억 개를 배운 모델과 비슷한 점수(0.109 대 0.111)에 닿았습니다. 표본 기준 42배, 텍스트 토큰 기준 14배 차이입니다.
읽은 글의 양으로도 견줘 봤습니다. 1억 900만 모델이 학습에서 읽은 토큰은 1,160억 개인데, 비교한 LLM들은 15조~18조 토큰으로 학습했습니다. 129~155배 적게 읽고 이 시험에서는 앞선 셈입니다(다대구 계산).
4. 그 짝의 3분의 2는 다른 AI가 쓴 설명이었습니다
숫자만큼 중요한 단서가 논문 7절 한계 항목에 있습니다. 학습에 쓴 웹 이미지 9억 4,000만 장은 사진마다 설명이 세 개씩 달려 있는데, 그중 두 개는 이미지 캡션 모델 LLaVA가 사진을 보고 만든 문장입니다.
텍스트 모델은 사진을 한 장도 보지 않았습니다. 대신 사진을 본 다른 AI의 눈이 문장을 거쳐 들어간 셈인데요. 사진 모델과 잘 맞는 결과가 나온 이유 가운데 일부는 여기서 왔을 가능성이 있습니다.
저자들이 밝힌 한계는 더 있습니다. 하이퍼파라미터는 좋은 관측 JEPA에만 맞췄고, 시험 문장 1,024개 중 최소 43개가 학습 자료에도 들어 있었습니다. 겹친 문장을 빼도 점수 변화는 0.002 이하였다고 덧붙였습니다.
5. 해커뉴스 댓글 85개를 갈래로 나눠 보니
이 논문은 11월 1일 해커뉴스에 올라와 170점을 받았고, 댓글이 85개 달렸습니다. 다대구가 답글을 뺀 첫 댓글 16개를 주제별로 나눴습니다.
가장 많은 5개는 철학·잡담 쪽이었고, 그다음이 ‘증명’이라는 표현을 의심하는 반응 4개였습니다. 한 이용자는 “가설을 증명한 건 아니고 낚시성 제목에 가깝지만, 학습 효율 개선은 흥미롭다”고 답글을 달았습니다.
기대하는 반응은 3개, 실험 방법을 묻는 댓글과 실용성을 묻는 댓글이 2개씩이었습니다. 다음 토큰 예측 모델의 은닉층을 어떻게 읽느냐에 따라 기준선 점수가 크게 달라진다는 지적도 그중 하나입니다.
공개 데모를 두고는 호평과 비판이 함께 나왔습니다. 예시 캡션이 틀렸다는 지적에 다른 이용자가 “사진·설명 짝을 한 번도 보지 않고 만든 걸 감안하면 놀라운 수준”이라고 답했습니다.
이 캡셔너는 고정된 이미지 모델과 텍스트 쪽을 회전 행렬 하나로 잇고, 그 행렬만 Flickr 사진·설명 3만 쌍으로 맞췄습니다. COCO 기준 CIDEr 점수는 0.838입니다.
6. 짝 없이 맞춘 시험에서는 80억 모델보다 약 17%포인트 높았습니다
논문에는 사진·설명 짝을 하나도 쓰지 않고 두 모델을 맞추는 시험도 있습니다. ImageNet-100 제로샷 분류 정확도에서 1억 900만 JEPA는 64.4%, 같은 조건으로 다시 돌린 Qwen3 80억 모델은 47.6%였습니다.
3,300만 파라미터짜리 JEPA도 57.9%로 Qwen3 80억 모델보다 높았습니다. 파라미터는 약 242배 차이입니다(다대구 계산).
다만 사진·설명 짝으로 직접 학습한 CLIP 텍스트 인코더는 68.7%로 여전히 가장 높았습니다. JEPA의 64.4%는 그 93.7% 수준입니다(다대구 계산).
7. 챗봇을 쓰는 사람에게 지금 바뀌는 것
당장은 없습니다. 이 모델은 대화하거나 글을 쓰는 모델이 아니고, 문장을 숫자로 바꾸는 인코더입니다. 지금 쓰는 챗봇을 이 연구 때문에 바꿀 이유는 없습니다.
직접 돌려 보려는 개발자에게는 아직 문턱이 있습니다. 공식 저장소(MIT 라이선스)는 11월 6일 기준 별 172개를 받았는데, 학습을 마친 텍스트 JEPA 체크포인트를 공개해 달라는 이슈가 11월 3일부터 열려 있습니다. 재현에는 최대 492GB의 텍스트 자료와 GPU가 필요합니다.
아마 이 논문이 업계에 남길 흔적은 모델 크기 쪽보다 데이터 쪽일 겁니다. 같은 장면을 여러 관점으로 담은 자료를 얼마나 모으느냐가 성능을 가른다는 주장이라, 사진·영상·센서 자료를 묶어 세계 모형을 만들려는 흐름과 맞닿아 있습니다.
르쿤이 줄곧 말해 온 방향도 결국 그쪽입니다. 앞서 다룬 구글 딥마인드 Genie 4 월드 모델이 영상으로 세상을 흉내 내는 길이라면, 이번 논문은 서로 다른 감각이 같은 세계 지도로 모인다는 걸 수학으로 붙잡으려는 시도입니다.
본문 그래프 2점은 논문·공식 저장소 수치로 다대구가 직접 계산·작성했습니다. 모든 점수는 저자들이 직접 측정한 값이며 독립 재현 결과는 아직 없습니다. 대표 이미지: 다대구 생성 이미지.