텐센트 Hy4의 점수표를 미국 최상위 모델 기준으로 다시 계산하면 하나의 패턴이 보입니다. 업무형 과제는 턱밑까지 따라붙었고, 연구 수학은 아직 13% 수준입니다.
텐센트가 11월 4일 새 모델 Hy4를 공개했습니다. 발표문 첫 문장은 “처음으로 Hy를 가장 강한 오픈소스 모델 반열에 올렸다”인데요.
텐센트가 함께 공개한 34개 항목 점수표를 미국 비공개 모델 최고점(GPT-6.1 Sol, Claude Opus 5.5)을 100으로 놓고 다시 계산해 봤습니다. 숫자가 한 방향으로 정렬됩니다.
에이전트 과제(Agents’ Last Exam)는 94, 컴퓨터 조작(OSWorld 2.1)은 96입니다. 최전선 코딩(FrontierCode 2.0)에서는 67로 떨어지고, 연구 수준 수학(Hy-FrontierMath T5)에서는 13까지 내려갑니다.
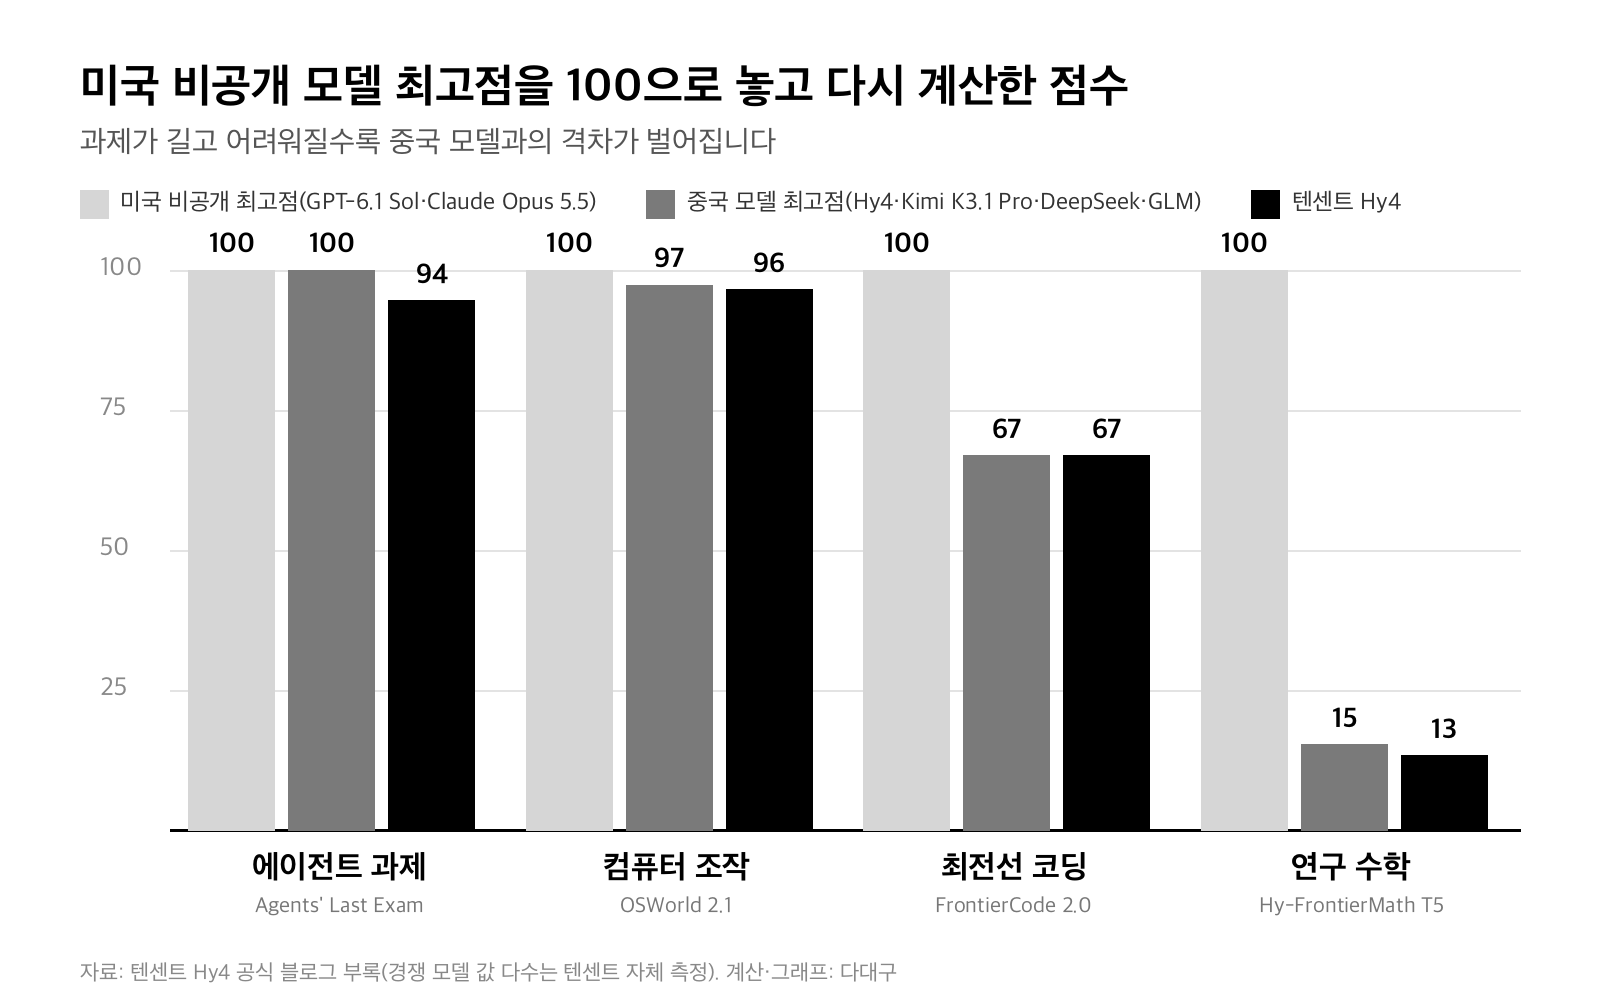
과제가 길고 추론이 깊을수록 격차가 벌어집니다. 그런데 이 모양은 Hy4만의 것이 아닙니다.
같은 표에 오른 Kimi K3.1 Pro, DeepSeek-V4.1-Flash, GLM-5.3 가운데 가장 높은 점수를 골라도 에이전트 과제 100, 컴퓨터 조작 97, 최전선 코딩 67, 연구 수학 15로 거의 같은 모양이 나옵니다.
중국 상위 모델들이 “업무를 대신 처리하는 능력”에서는 미국 최상위와 사실상 같은 선에 섰지만, “새로운 문제를 깊게 푸는 능력”에서는 아직 다른 리그에 있다는 뜻입니다.
다만 경쟁 모델 점수 상당수는 텐센트가 직접 잰 값입니다. 제3자 평가는 아직 없습니다.
1. 두 달 사이 바뀐 것: 화면을 보고, 직접 조작합니다
텐센트는 7월 초 Hy3, 8월 말 Hy4 프리뷰를 냈고, 약 두 달 뒤 정식판을 내놓았습니다.
가장 크게 달라진 건 에이전트 능력입니다. 터미널에서 실제 작업을 끝내는 Terminal-Bench 4.0은 프리뷰 26.3점에서 44.4점으로 1.7배가 됐고, 업무 대행을 보는 APEX-Agents는 53.9점에서 75.2점이 됐습니다.
Hy 계열 처음으로 이미지 인식과 컴퓨터 조작도 들어갔습니다. 블렌더·CAD 같은 전문 소프트웨어와 여러 앱을 오가는 긴 작업을 학습시켰다고 합니다. 첫 버전인데도 OSWorld 2.1에서 78.9점으로, Claude Opus 5.5(81.8점)와 3점 차이입니다.
다대구가 앞서 다룬 terminal-mac이나 voxl처럼, 최근 오픈소스 도구들은 “AI 에이전트에게 컴퓨터를 쥐여 주는” 쪽으로 몰리고 있습니다. 모델에서도 같은 능력이 기본 사양이 되고 있습니다.
2. 가격: 고가 모델과 초저가 모델 사이에 섰습니다
Hy4의 공식 정가는 100만 토큰당 입력 0.834달러, 출력 2.501달러입니다. 프리뷰와 같은 가격입니다.
오픈라우터 표시 가격과 나란히 놓으면 위치가 분명해집니다. 출력 기준으로 Claude Opus 5.5(20달러)의 8분의 1, GPT-6.1 Sol과 Kimi K3.1 Pro(10달러)의 4분의 1입니다. 반대로 GLM-5.3(1.4달러)보다는 1.8배, DeepSeek-V4.1-Flash(0.6달러)보다는 4배 비쌉니다.
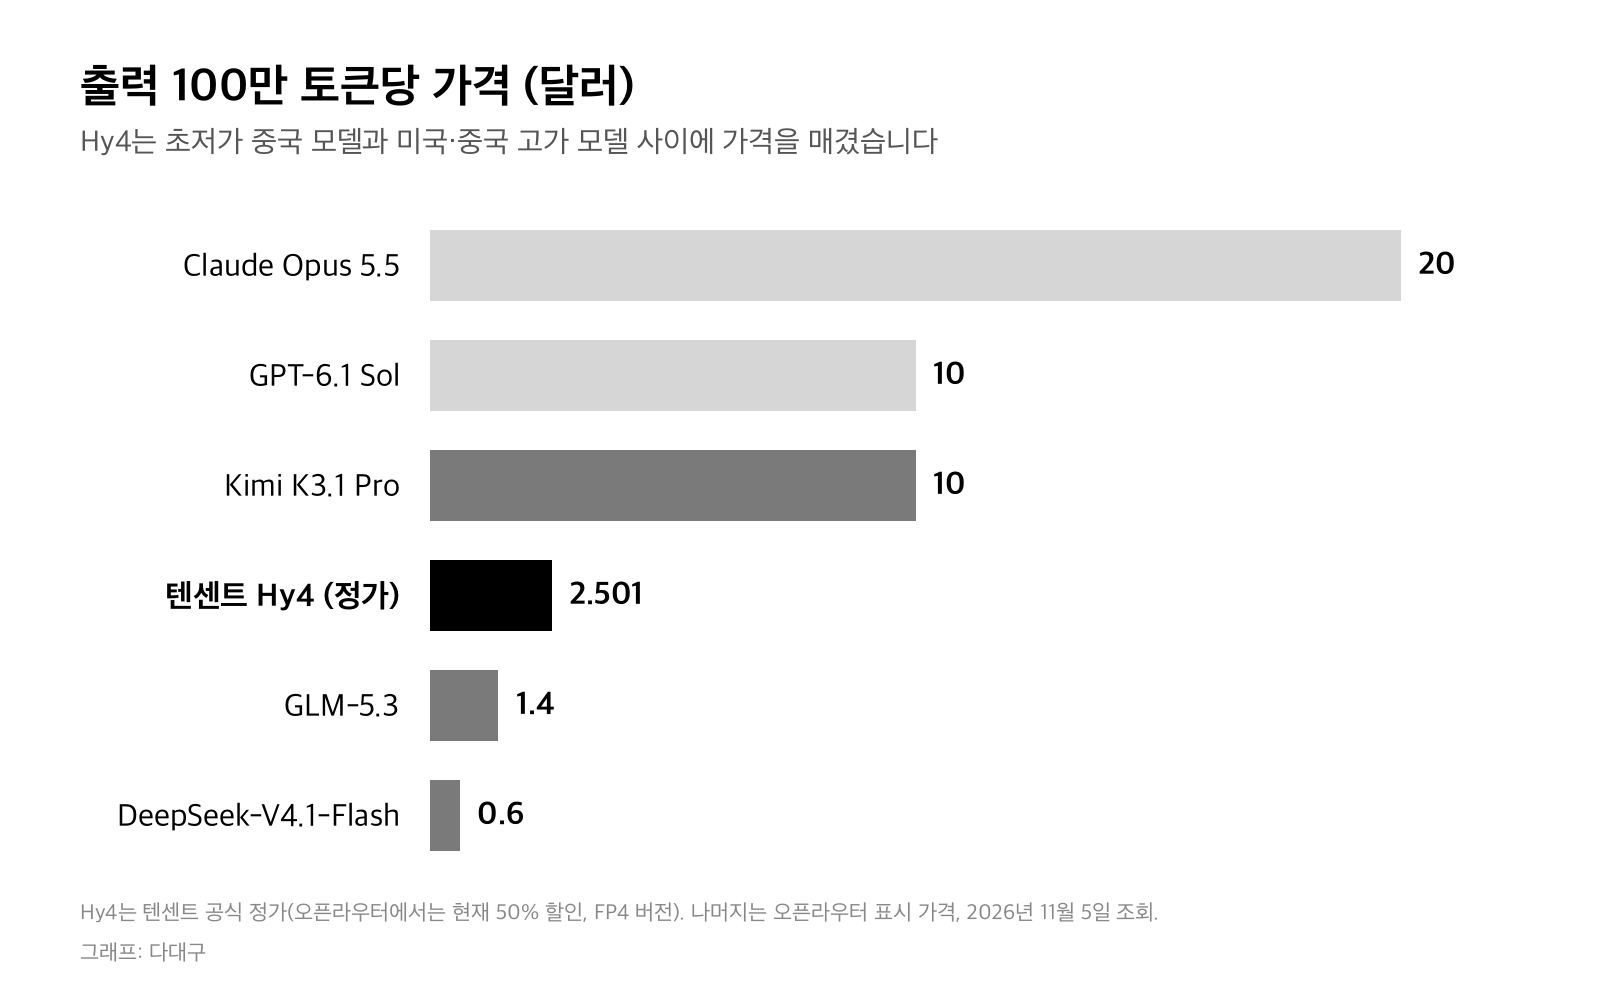
저는 이 가격이 이번 발표의 핵심 전략이라고 봅니다. 연구 수학 같은 최상위 경쟁에서 이기려 하기보다, 업무형 과제에서 최상위의 95% 성능을 내면서 값은 4분의 1에서 8분의 1만 받겠다는 겁니다. 회사 업무 자동화처럼 “충분히 잘하면 되는” 시장을 정면으로 노린 가격입니다.
오픈라우터는 지금 Hy4를 반값에 파는데, 4비트(FP4)로 압축한 버전입니다. 텐센트는 벤치마크를 어떤 정밀도로 측정했는지 밝히지 않았습니다.
3. 증명 방식도 바꿨습니다: 전문가 채점과 오답률
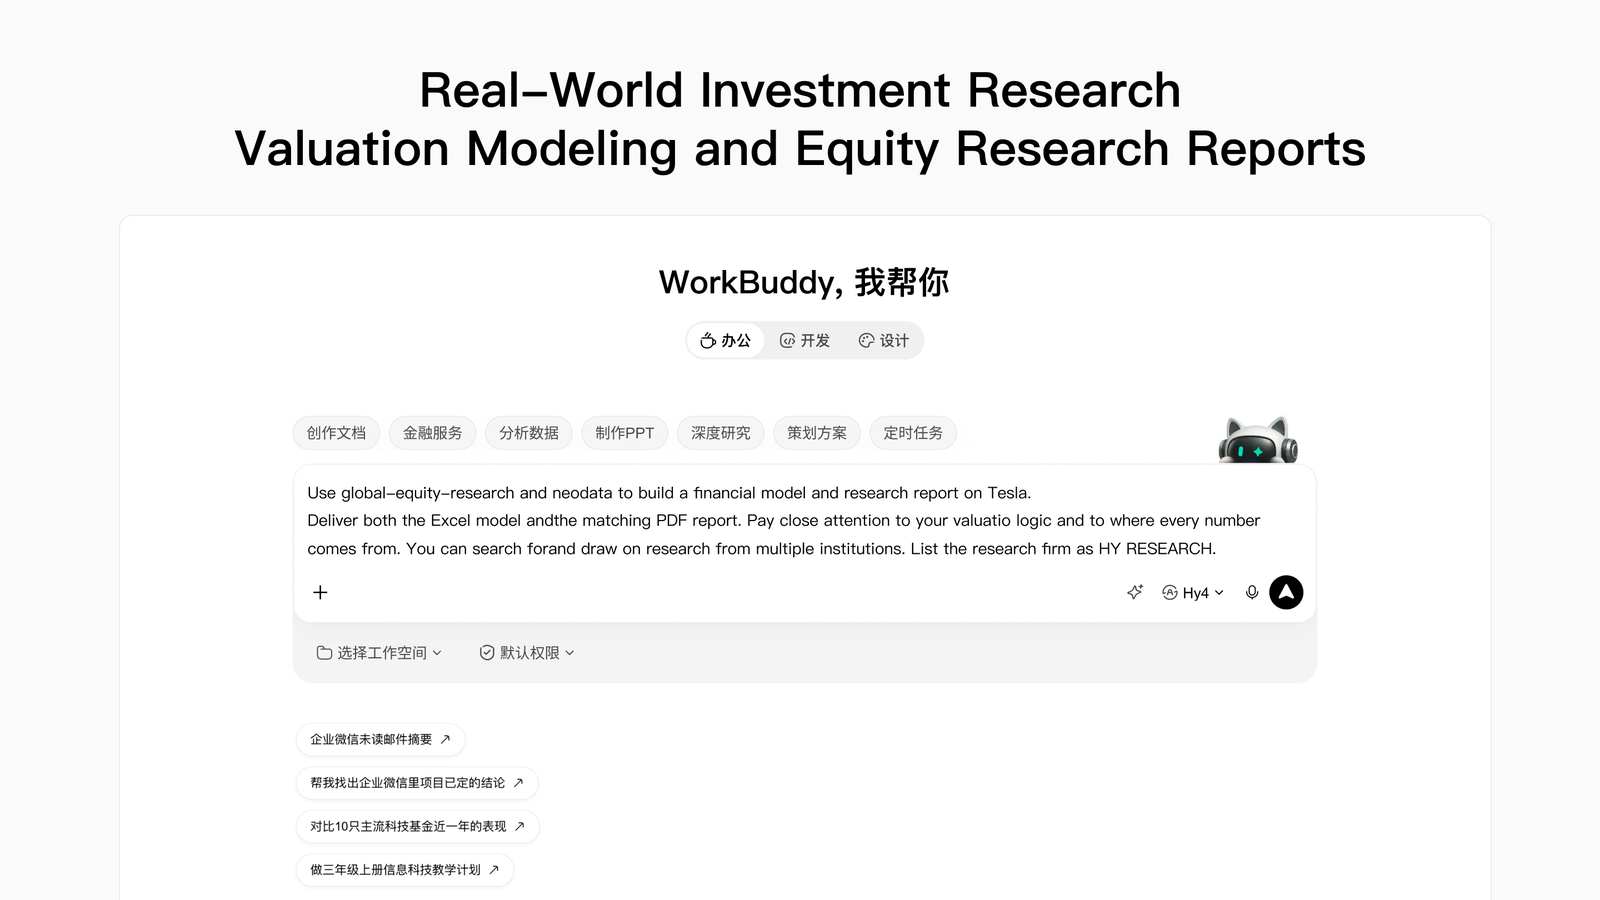
“충분히 잘한다”를 증명하는 방식도 달랐습니다. 텐센트는 사내 핀테크 조직(FiT)과 함께 금융 전문가 213명을 모았는데요. 153명이 금융기관 소속이고 70% 이상이 5년 넘는 경력자입니다. 이들이 실제 업무를 본뜬 579개 과제의 결과물을 직접 채점했습니다.
결과는 Hy4 3.04점, DeepSeek-V4.1-Flash 2.97점, Kimi K3.1 Pro 2.68점, GLM-5.3 2.68점으로, 공개 가중치 모델 가운데 1위였습니다.
업무에서 가장 비싼 실수인 “그럴듯한 오답”을 줄였다는 점도 강조했습니다. 텐센트 내부 평가에서 환각률은 15.76%에서 5.45%로 약 3분의 1이 됐고, 근거 없이 추측해 답하는 비율은 23.1%에서 5.6%로 내려갔습니다.
정답이 정해진 시험보다 “현업 전문가가 이 결과물을 쓸 수 있다고 보느냐”, “틀린 말을 얼마나 덜 하느냐”를 내세운 겁니다. 앞서 다룬 구글 제미나이 4 카본이 사이버 보안과 장시간 작업을 앞세운 것과 같은 흐름으로, 모델 회사들의 증명 방식이 점수에서 실무 신뢰성으로 옮겨 가고 있습니다.
4. ‘가장 강한 오픈소스’는 아직 조건부입니다
텐센트는 오픈소스를 앞세웠지만, 11월 5일 기준 정식판 가중치는 받을 수 없습니다. 허깅페이스의 Hy4 저장소는 비공개 상태이고, 텐센트는 공개 “계획”과 함께 그때 시스템 카드를 내겠다고만 밝혔습니다.
같은 표의 다른 모델들은 사정이 다릅니다. Hy3와 Hy4 프리뷰는 아파치 2.0으로 공개돼 있고, DeepSeek-V4.1-Flash는 10월 17일 MIT 라이선스로 공개됐습니다. Kimi K3.1 Pro와 GLM-5.3도 허깅페이스에 가중치가 올라와 있습니다. 같은 표 안에서 지금 내려받을 수 없는 모델은 Hy4뿐입니다.
지금 Hy4는 “가장 강한 오픈소스 모델”이라기보다 “API로 먼저 내놓은 공개 예정 모델”에 가깝습니다. 프리뷰는 전체 7,700억 개 중 490억 개 파라미터만 쓰는 구조였는데, 정식판 파라미터 수는 이번에 밝히지 않았습니다.
5. 한국에서 써 볼 만할까
Hy4는 지금 텐센트 클라우드와 오픈라우터 API로 바로 쓸 수 있습니다. 오픈라우터 기준으로 텍스트와 이미지를 넣을 수 있고, 한 번에 100만 토큰까지 읽습니다.
문서 정리, 자료 조사, 여러 앱을 오가는 반복 업무처럼 에이전트 과제 성격의 일이라면 비용 대비 후보가 될 수 있습니다. 반대로 새로운 알고리즘 설계, 수학적 증명, 최전선 수준의 코딩은 위 그래프의 오른쪽 두 칸이 보여 주듯 아직 미국 최상위 모델과 차이가 큽니다.
회사 데이터를 넣을 생각이라면 데이터가 어느 지역에서 처리되고 얼마나 보관되는지부터 텐센트 클라우드와 오픈라우터 약관에서 확인해야 합니다.
6. 판이 두 층으로 나뉘고 있습니다
이번 점수표에는 AI 시장이 두 층으로 갈라지는 모습이 선명하게 드러납니다.
위층은 연구 수학과 최전선 코딩처럼 깊은 추론이 필요한 일입니다. 미국 비공개 모델들이 높은 가격을 받으며 앞서 있습니다. 아래층은 업무 대행과 컴퓨터 조작입니다. 중국 상위 모델들이 최상위의 95% 성능을 4분의 1에서 8분의 1 가격에 내놓고 있습니다.
아마 앞으로 몇 달은 이 아래층에서 경쟁이 가장 치열할 겁니다. 다음에 볼 숫자는 세 가지입니다. 텐센트가 곧 내놓겠다는 경량판 Hy4 flash의 가격, 정식판 가중치 공개 시점, 그리고 제3자 평가에서 텐센트 자체 점수가 얼마나 유지되는지입니다.
출처: Tencent Hunyuan, Introducing Hy4 (2026-11-04), Hugging Face, Hy4-preview, Hugging Face, Hy3, Hugging Face, DeepSeek-V4.1-Flash-1017, Hugging Face, Kimi-K3.1-Pro, Hugging Face, GLM-5.3, OpenRouter 모델 가격 (2026-11-05 조회), 财联社
본문 그래프 2점은 공개 자료를 바탕으로 다대구가 직접 계산·작성했습니다. 시연 이미지 2점: Tencent Hunyuan 공식 블로그. 대표 이미지: 다대구 생성 이미지.