앤트로픽이 11월 9일(현지 시각) 내놓은 Claude Fable 5.2는 벤치마크 10개 모두에서 Opus 5.5를 앞섰습니다. 바로 전 버전인 Fable 5.1은 같은 10개 가운데 9개에서 Opus 5.5에 졌던 모델입니다.
그런데 값은 여전히 Opus 5.5의 2배입니다. 다대구가 10개 점수를 Opus 5.5 점수로 나눠 보니, 2배 값에 가까운 차이를 낸 과제는 원격 노동 하나뿐이었는데요. 어떤 일에 페이블을 쓰고 어떤 일은 Opus로 충분한지 숫자로 나눠 봤습니다.
1. 값은 20% 내렸지만, 여전히 Opus 5.5의 2배입니다
Fable 5.2의 API 가격은 100만 토큰당 입력 8달러, 출력 40달러입니다. Fable 5.1의 10달러·50달러에서 정확히 20% 내렸습니다.
같은 표에서 Opus 5.5는 입력 4달러, 출력 20달러입니다. 출력 100만 토큰을 11월 10일 한국은행 기준 환율 1,355.7원으로 바꾸면 페이블은 약 5만 4천 원, Opus는 약 2만 7천 원인데요. 가격을 내렸어도 두 모델의 간격은 그대로 2배입니다.
속도와 거절도 바뀌었습니다. 앤트로픽은 출력이 5.1보다 최대 30% 빨라졌고, 차단되는 요청이 약 55% 줄었다고 밝혔습니다. 보안 분야는 약 60%, 생물학 분야는 약 40% 줄었다는 설명입니다.
급한 작업에는 빠른 모드를 쓸 수 있습니다. 출력 속도가 최대 2.5배 빨라지는 대신 값은 입력 16달러, 출력 80달러로 2배가 됩니다. 컨텍스트는 100만 토큰, 한 번에 받는 출력은 최대 12만 8천 토큰입니다.
2. 5.1은 반값 모델에 졌고, 5.2는 10개 모두 이겼습니다
앤트로픽이 발표한 점수표에는 Fable 5.2, Fable 5.1, Opus 5.5가 같은 벤치마크로 나란히 있습니다. 각 모델이 가장 높은 추론 강도로 낸 점수입니다.
Fable 5.1은 지식 업무(AA-Briefcase) 하나에서만 Opus 5.5보다 0.3%포인트 높았습니다. 나머지 9개는 반값인 Opus 5.5가 더 높았는데요. 비싼 모델이 싼 모델에 지는 이상한 구도가 5.2에서 정리된 셈입니다.
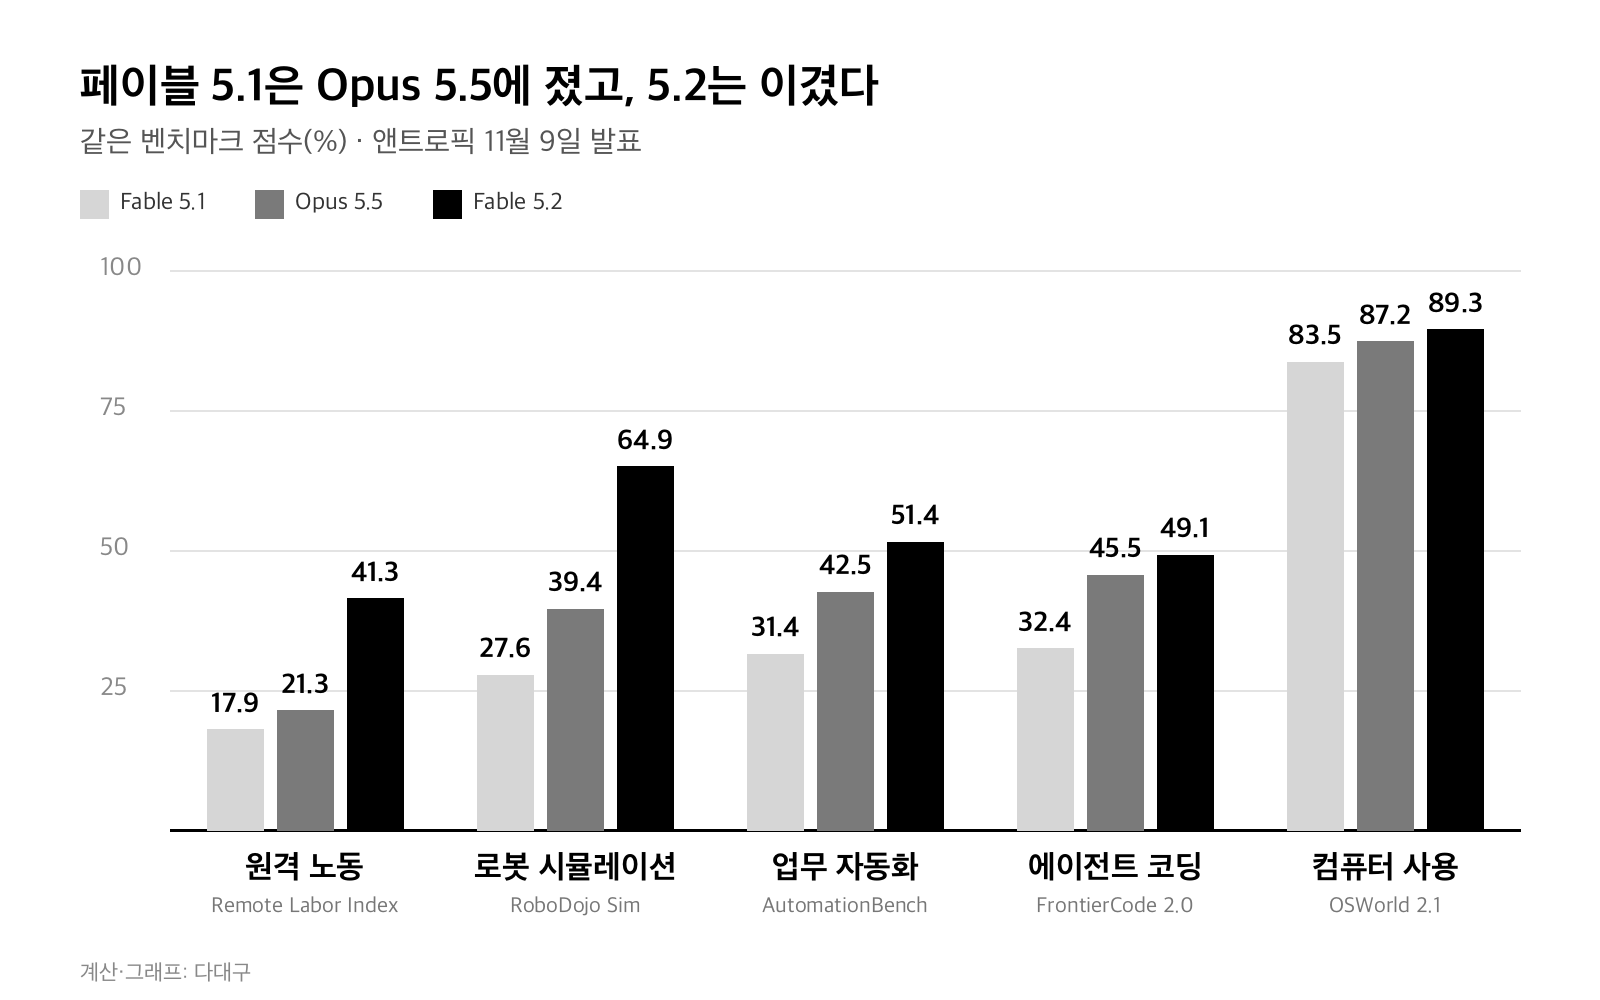
가장 크게 뛴 곳은 로봇 시뮬레이션(RoboDojo Sim)입니다. 27.6%에서 64.9%로 2.35배가 됐습니다. 원격 노동(Remote Labor Index)도 17.9%에서 41.3%로 2.31배입니다.
반대로 컴퓨터 사용(OSWorld 2.1)은 83.5%에서 89.3%로 5.8%포인트만 올랐습니다. 이미 점수가 높은 과제라 더 오를 자리가 적었습니다.
3. 2배 값을 하는 과제는 원격 노동과 로봇 정도입니다
값이 2배라면 점수도 2배 가까이 나와야 같은 돈값이라고 볼 수 있습니다. Fable 5.2 점수를 Opus 5.5 점수로 나눠 봤습니다.
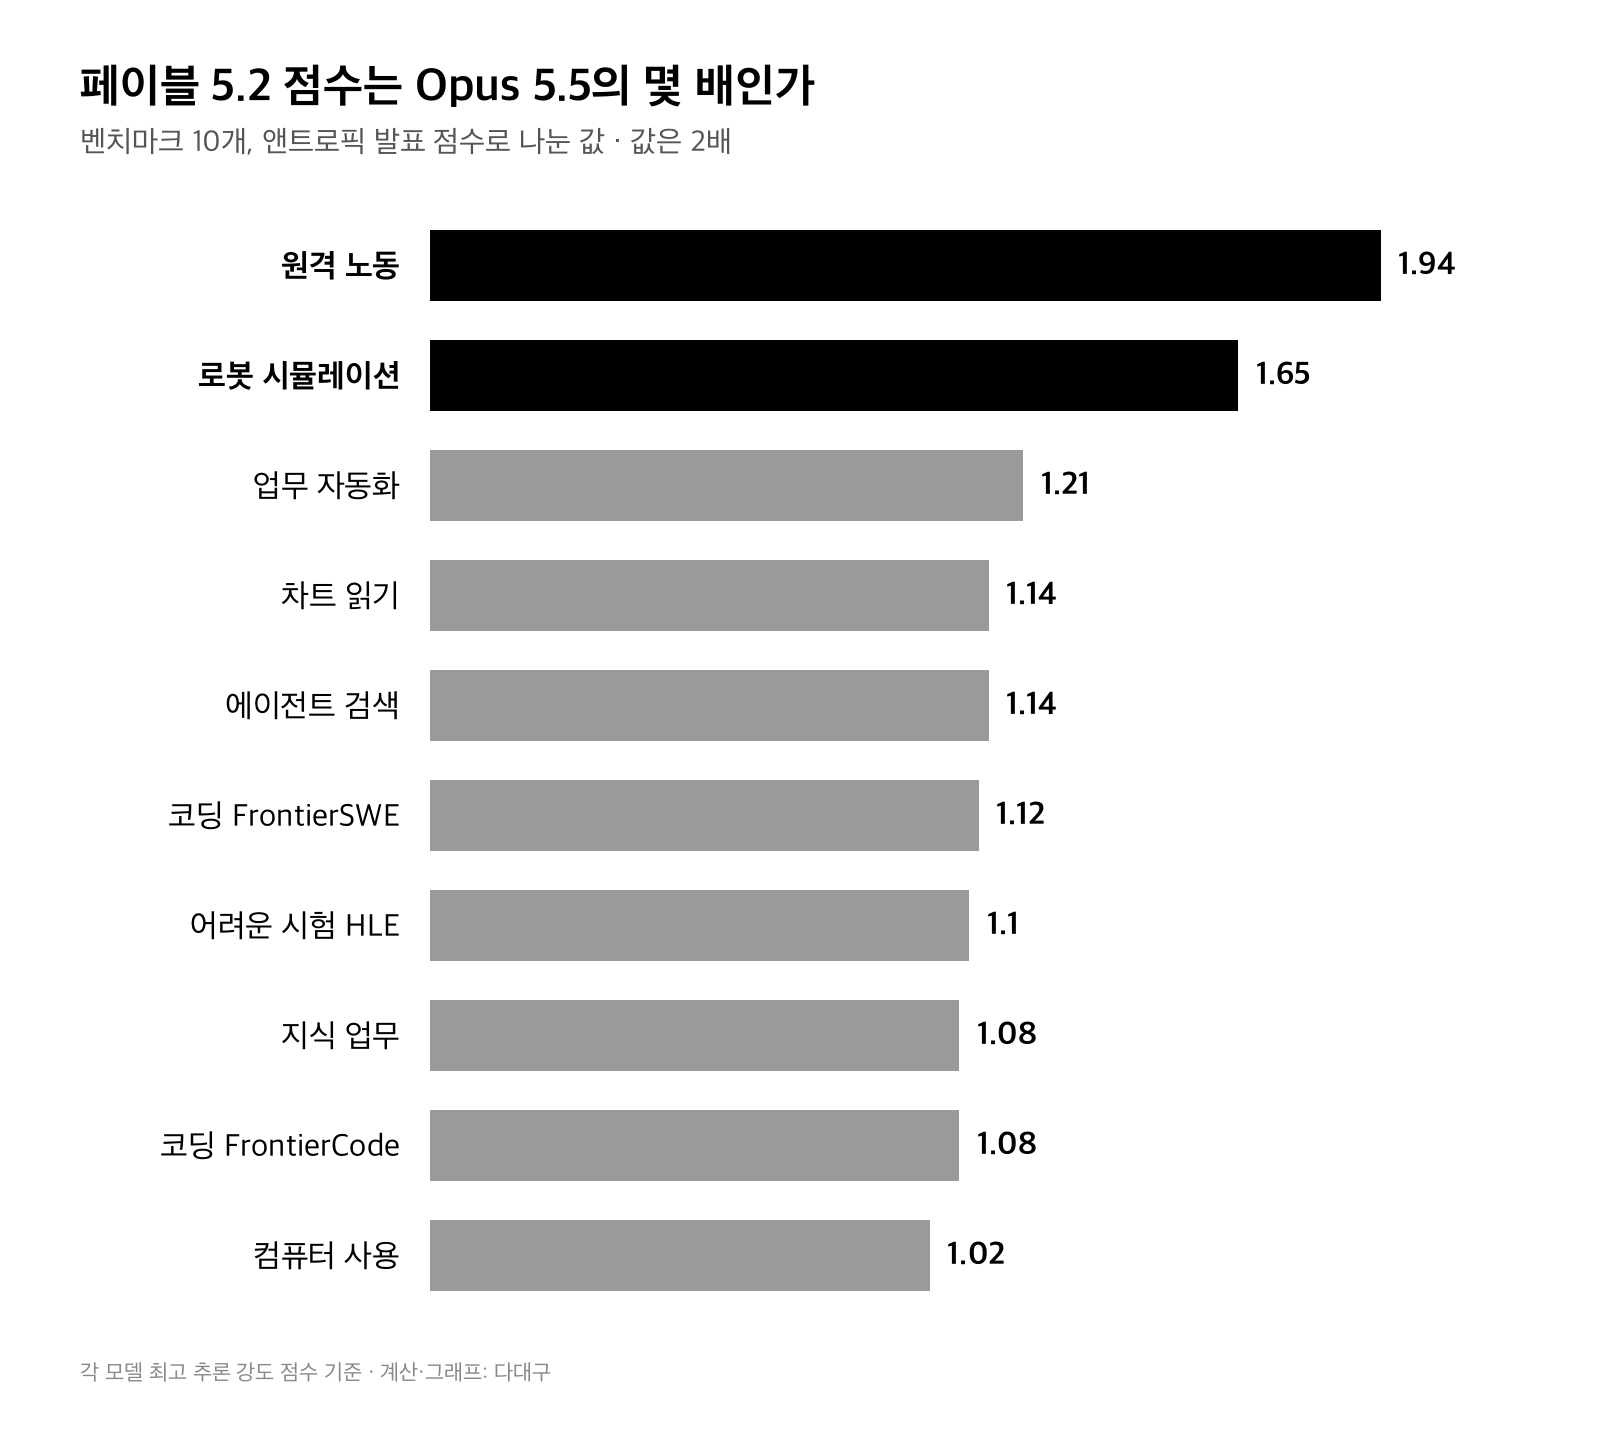
원격 노동이 1.94배로 가장 높고, 로봇 시뮬레이션이 1.65배로 뒤를 잇습니다. 10개의 가운데 값은 1.13배인데요. 대부분 과제에서 페이블은 Opus보다 10%쯤 더 잘하고 값은 2배 받는다는 뜻입니다.
에이전트 코딩(FrontierCode 2.0)은 49.1% 대 45.5%로 1.08배, 컴퓨터 사용은 89.3% 대 87.2%로 1.02배입니다. 업무 자동화(AutomationBench)에서는 구글 Gemini 4 Carbon이 53.9%로 Fable 5.2(51.4%)보다 높았습니다.
원격 노동과 로봇은 한 번에 끝나지 않고 여러 단계를 오래 이어 가야 하는 과제입니다. 저는 페이블의 값이 이런 긴 과제에서만 제값을 한다고 봅니다. 앤트로픽의 다이앤 펜도 CNBC 인터뷰에서 Fable 5.2를 ‘파워 유저나 파워 유스케이스’를 위한 모델이라고 했습니다.
4. 작업 하나로 계산하면 3.6달러와 1.8달러입니다
캐시를 쓰지 않는 입력 20만 토큰, 출력 5만 토큰짜리 작업 하나를 API로 돌린다고 가정해 봤습니다. 긴 코드 저장소를 읽고 수정안을 내는 정도의 양입니다.
Fable 5.2는 입력 1.6달러에 출력 2달러로 3.6달러, 약 4,880원입니다. Opus 5.5는 1.8달러(약 2,440원), Fable 5.1은 4.5달러(약 6,100원)입니다. 같은 작업을 빠른 모드로 돌리면 7.2달러(약 9,760원)가 됩니다.
이런 작업을 한 달에 100번 하면 페이블과 Opus의 차이는 180달러, 약 24만 4천 원입니다. 점수 차이가 10%인 과제라면 이 돈을 더 낼 이유가 약합니다.
같은 문서를 되풀이해 읽는 작업은 계산이 달라집니다. Fable 5.2의 캐시 읽기는 100만 토큰당 0.2달러로 기본 입력값의 2.5%입니다. 이때는 입력 비용이 크게 줄어 출력 단가가 차이를 좌우합니다.
앞서 다룬 Claude Max·Ultra 요금제 계산에서도 봤듯, 구독자는 토큰값 대신 주간 한도로 비용을 치릅니다. 앤트로픽은 Pro와 Team 일반 좌석에서 페이블을 주간 사용 한도의 50%까지만 쓸 수 있게 했습니다.
5. 한국에서 써 볼 만할까
Claude 앱은 Pro, Max, Ultra, Team, Enterprise 요금제에서 발표 당일부터 Fable 5.2를 고를 수 있습니다. 무료 요금제는 대상 목록에 없습니다. 출시 기념으로 구독 기간에 따라 페이블 한도를 1~3번 다시 채워 줍니다.
앱과 Claude Code에서 기본 추론 강도는 중간(Medium)입니다. API는 높음(high)이 기본이라, 같은 질문도 어디서 쓰느냐에 따라 토큰 사용량이 달라집니다.
Pro 요금제를 쓴다면 페이블은 주간 한도의 절반을 빨리 쓰는 모델입니다. 평소 일은 Opus 5.5로 하고, 여러 파일을 오래 고치거나 단계가 긴 조사를 맡길 때만 페이블로 바꾸는 쪽이 한도를 아끼는 방법일 겁니다. 점수표로 보면 코딩 한 번, 문서 한 장 정도의 일에서는 차이를 느끼기 어렵습니다.
국내 연구도 비슷한 방향을 보여 줍니다. 한국콘텐츠진흥원 김지현 연구원이 2026년 한국방송학보에 낸 연구는 콘텐츠산업 프리랜서 1,275명 가운데 생성형 AI를 쓰는 528명을 분석했는데요. 일주일에 자주 쓰는 사람일수록 업무 시간 단축과 생산성 향상을 더 높게 평가했습니다.
저는 이 결과를 비싼 모델 하나보다 맞는 모델을 자주 쓰는 쪽이 체감 효율을 만든다는 뜻으로 읽습니다. 같은 연구에서 업무 효율이 직업 만족도로 곧바로 이어지지는 않았다는 점도 함께 볼 만합니다.
함께 나온 Mythos 5.2는 Fable 5.2와 같은 모델에서 보안·생물학 안전장치 일부를 뺀 버전입니다. 앤트로픽의 보안·생명과학 인증 프로그램에 신청해 승인받은 기관만 씁니다. 일반 사용자가 고를 수 있는 최상위 모델은 Fable 5.2입니다.
앞서 다룬 ‘Fable 5.5’ 사례 글을 쓸 때 공식 목록의 최상위 모델은 Fable 5.1이었습니다. 실제로 나온 다음 번호는 5.2였습니다.
참고 논문: 김지현(2026), ‘콘텐츠산업 프리랜서의 생성형 AI 활용과 직업 만족도: 업무 효율성을 경유한 간접효과와 노동 경험의 차이를 중심으로’, 한국방송학보 40(5).
본문 그래프 2점은 앤트로픽이 11월 9일 공개한 점수표를 바탕으로 다대구가 직접 계산·작성했습니다. 대표 이미지는 앤트로픽 공식 이미지입니다.