앤트로픽에서 Claude Code를 만드는 애디 오스마니가 11월 3일 “Critical thinking when agents do the work”라는 글을 올렸습니다. 에이전트가 일을 잘할수록 사람은 확인을 멈추고, 그 끝에 ‘인지적 항복’이 온다는 경고였습니다.
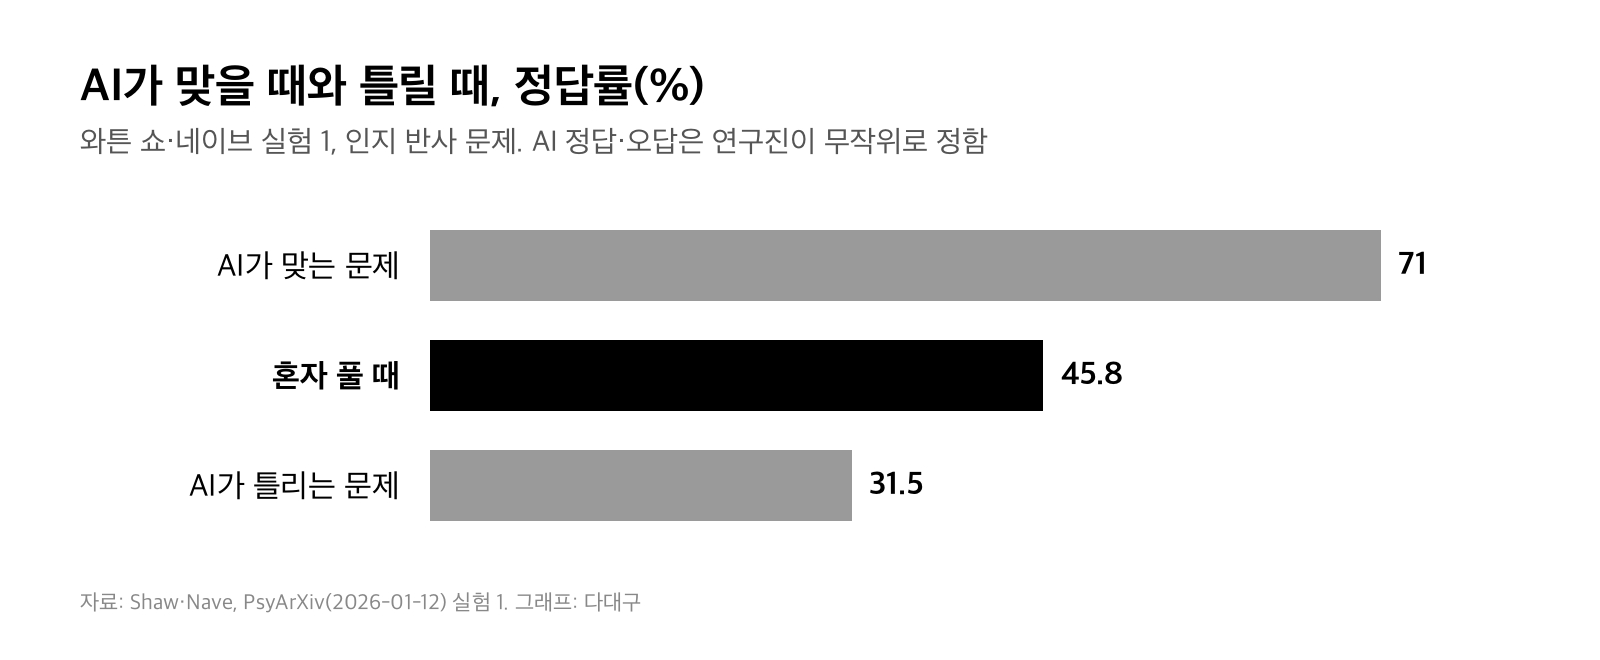
이 말을 만든 와튼스쿨 연구진의 실험을 다시 열어 보면 그 경고가 숫자로 나옵니다. 혼자 풀 때 정답률은 45.8%였는데, AI가 틀린 답을 내민 문제에서는 31.5%로 떨어졌습니다. 그런데 AI를 쓴 사람들의 자신감은 오히려 11.7%포인트 올랐는데요.
오스마니의 글과 지난 5월 블로그 글, 그리고 원 논문 PDF의 표를 함께 놓고 에이전트를 쓰는 사람이 실제로 무엇을 조심해야 하는지 정리했습니다.
1. 오스마니가 말한 세 단계
오스마니는 구글에서 14년 넘게 일하며 크롬 개발자 도구와 구글 클라우드 AI 개발자 경험을 이끌었고, 지금은 앤트로픽에서 Claude Code를 만듭니다. 11월 3일 글 원문은 X에 올라온 장문이라 이번에 직접 열지 못해, 이 글은 그 내용을 전한 보도와 같은 주제를 먼저 다룬 그의 블로그 글을 함께 근거로 씁니다.
11월 3일 글을 소개한 토큰포스트 기사에 따르면, 그는 에이전트가 팀의 검증 속도보다 빨리 소프트웨어를 만들어 사람이 설명하지 못하는 결정까지 책임지게 된다고 경고했습니다.
그가 나눈 단계는 셋입니다. 처음에는 결과를 확인하며 맡깁니다.
다음에는 에이전트의 답을 그대로 다음 작업의 근거로 씁니다. 마지막에는 결과를 의심하지 않고 받아들이는데, 이 마지막 단계가 인지적 항복입니다.
그는 지난 5월 블로그 글에서 둘을 이렇게 갈랐습니다. 위임은 ‘어떻게’를 넘기되 ‘무엇’은 쥐고 결과가 말이 되는지 판단하는 일입니다. 항복은 비교할 내 생각을 만든 적도 없이 AI의 출력이 내 출력이 되는 상태입니다.
11월 글에는 새 용어도 생겼습니다. 에이전트가 만드는 양과 사람이 검토할 수 있는 양의 차이를 ‘오케스트레이션 세금’이라고 불렀고, 목표와 제약을 적지 않아 에이전트가 대신 내린 선택은 ‘의도 부채’라고 했습니다.
2. 와튼 실험: AI가 틀리면 혼자보다 못합니다
‘인지적 항복’은 와튼스쿨 스티븐 쇼와 기디언 네이브가 1월 공개한 논문에서 나온 말입니다. 사전 등록한 실험 3개에서 1,372명이 9,593번 문제를 풀었고, 연구진은 숨긴 지시로 AI 도우미가 맞는 답을 낼지 틀린 답을 낼지 문제마다 무작위로 정했습니다.
문제는 직관으로 답하면 틀리기 쉬운 인지 반사 검사였습니다. 참가자들은 절반이 넘는 문제에서 AI에 물었고, 실험 1에서 AI가 맞는 문제의 54.4%, 틀리는 문제의 52.8%에서 대화창을 열었습니다.
일단 물어본 뒤에는 거의 따랐습니다. AI가 맞을 때 92.7%를 따랐고, 틀릴 때도 79.8%를 따랐습니다. 틀린 답을 거부한 비율은 20.2%였습니다.
정답률은 그래프와 같습니다. 혼자 푼 사람의 정답률 45.8%를 기준으로 AI가 맞는 문제는 25.2%포인트 올라갔고, 틀리는 문제는 14.3%포인트 내려갔습니다(다대구 계산). AI가 틀린 문제에서 정답률은 혼자 풀 때의 약 69%였습니다.
3. 틀려도 자신감은 오릅니다
자신감 숫자는 더 놀랍습니다. 문제의 절반가량에서 AI가 틀린 답을 줬는데도, AI를 쓴 사람들의 자신감은 평균 77.0%로 혼자 푼 사람(65.3%)보다 11.7%포인트 높았습니다.
틀린 답을 받은 문제가 많아져도 자신감은 의미 있게 줄지 않았습니다. 연구진은 이를 항복의 행동 흔적으로 봤습니다. 틀렸다는 신호가 와도 사람이 알아채지 못한다는 뜻입니다.
오스마니는 이 현상이 개발자에게 특히 위험한 이유를 블로그에 네 가지로 적었습니다. 생성된 코드는 컴파일되고 돌아가서 겉으로는 맞아 보이고, 처리량 지표는 이해한 일과 승인만 한 일을 구분하지 못합니다. 모델의 단정적인 말투가 리뷰어에게 옮겨 가고, 한 번 받아들인 덩어리가 다음 덩어리를 검토하기 더 어렵게 만듭니다.
그는 이렇게 쌓인 빚을 ‘이해 부채’라고 불렀습니다. 시스템에 있는 코드의 양과 사람이 실제로 이해하는 양의 차이이고, 그 값은 아무도 시스템을 처음부터 다시 설명하지 못하는 날에 치르게 됩니다.
누가 더 잘 넘어가는지도 나왔습니다. AI를 많이 믿는 사람, 깊이 생각하기를 덜 즐기는 사람, 유동 지능 점수가 낮은 사람일수록 AI 오답을 더 많이 따랐습니다.
4. 시간에 쫓기면 AI 오답에 더 끌려갑니다
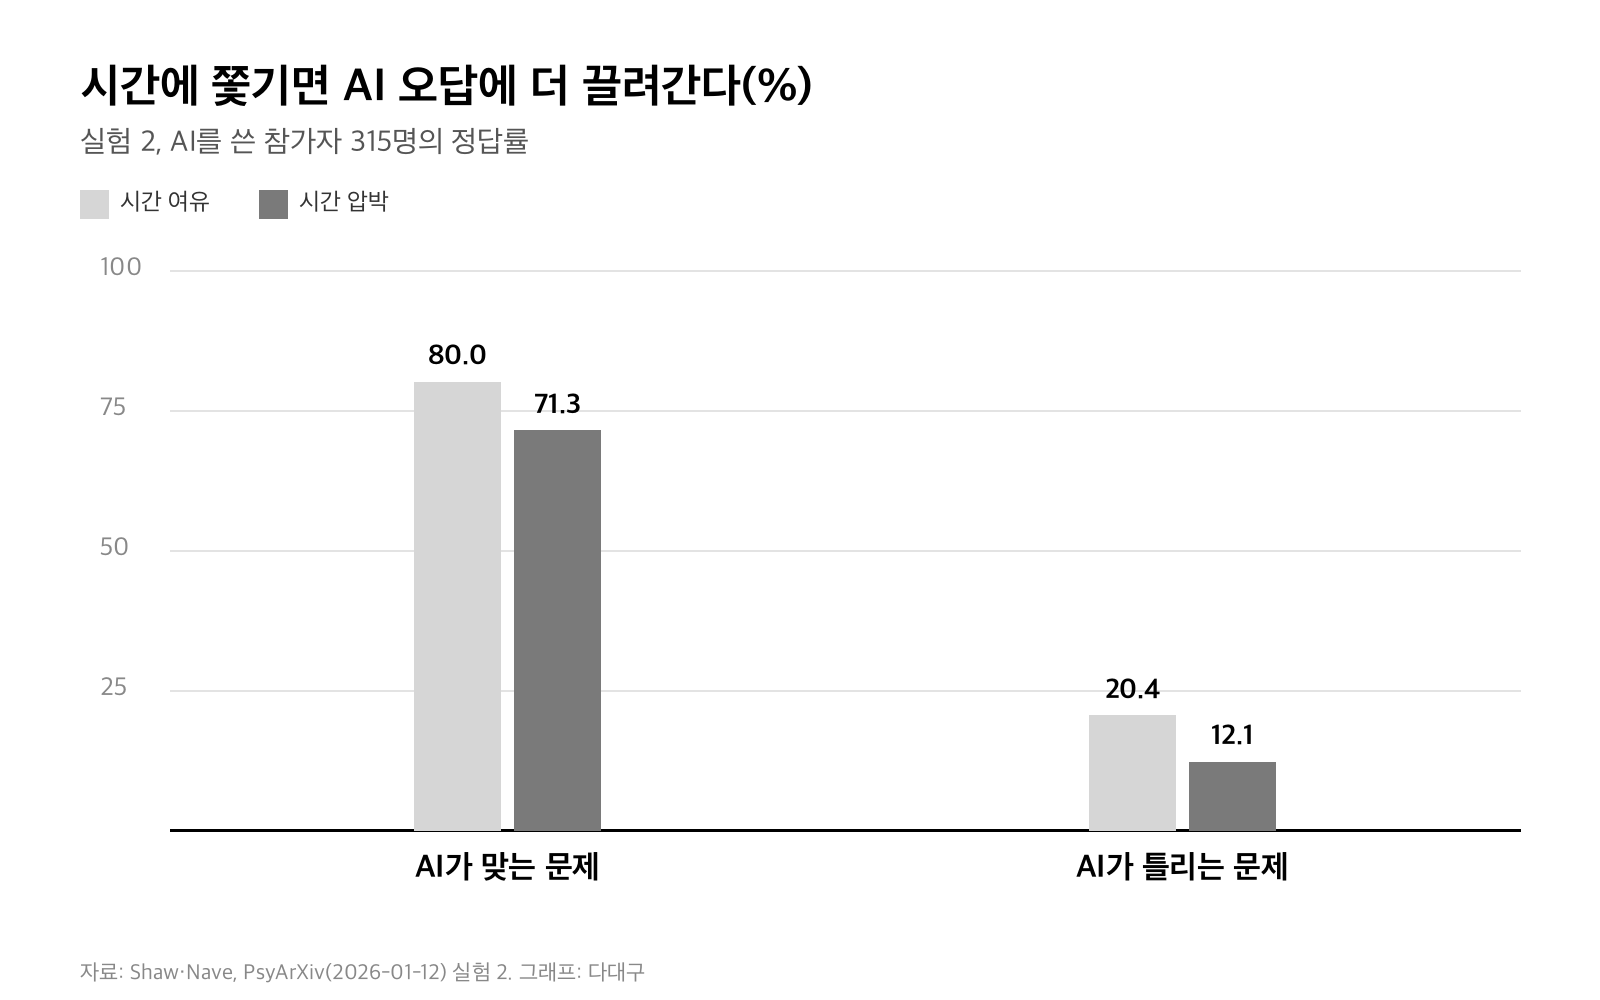
실험 2는 시간 압박을 더했습니다. AI를 쓴 참가자 315명의 정답률은 AI가 맞는 문제에서 시간 여유가 있을 때 80.0%, 쫓길 때 71.3%였습니다.
AI가 틀리는 문제에서는 여유 있을 때 20.4%, 쫓길 때 12.1%였습니다. 시간 압박에서 AI 오답 문제의 정답률은 여유 있을 때의 약 59%로 줄었습니다(다대구 계산). 실험 3에서 문제마다 보상과 피드백을 줘도 이 패턴은 사라지지 않았습니다.
저는 이 결과가 에이전트 작업과 가장 가깝다고 봅니다. 마감 직전, 에이전트 여러 개가 한꺼번에 결과를 쏟아 낼 때가 바로 시간에 쫓기며 AI 답을 받는 상황이기 때문입니다. 오스마니가 블로그에서 ‘피로할 때 항복이 늘어난다’고 적은 것도 같은 방향입니다.
5. 에이전트에 맡길 때 던질 질문
오스마니의 두 글에서 실제로 쓸 수 있는 습관을 질문으로 묶었습니다. 하나씩 지키기 어렵다면 첫 질문만이라도 붙잡는 게 좋습니다.
- 맡기기 전에 성공 기준을 적었나? 무엇이 나오면 끝난 것인지 먼저 정합니다.
- 답을 보기 전에 내 예상을 적었나? 예상과 다르면 누가 틀렸는지 판단할 기회가 생깁니다.
- 이 답이 틀리려면 무엇이 사실이어야 하나? 모델에게 스스로 반론을 펴게 하는 것도 방법입니다.
- 테스트는 무엇을 확인했고, 무엇을 확인하지 않았나? 통과했다는 사실만으로는 리뷰가 아닙니다.
- 에이전트가 실제로 실행한 명령과 기록을 봤나? 끝났다는 말 대신 로그·테스트 기록 같은 증거로 끝을 정합니다.
- 나는 지금 지쳐 있나? 검토가 밀리면 자동 검사를 늘리거나 만드는 속도를 늦춥니다.
그는 정기적으로 AI 없이 코드를 써 보라고도 권했습니다. 8월 글에서는 “에이전트는 아무것도 가르쳐 주지 않고 일을 끝낼 수 있다”고 적었습니다.
6. 반응은 공감과 반론이 반반
11월 1일 해커뉴스에 올라온 다른 개발자의 글 ‘Resisting Cognitive Surrender’는 335점, 댓글 163개를 받았습니다. 최상위 댓글 30개를 다대구가 나눠 보니 ‘실제로 겪고 있다’는 공감이 9건, ‘계산기 때와 같은 걱정’이라는 반론도 9건이었습니다.
공감 쪽에는 “생성된 코드 수천 줄을 매일 ‘좋아 보인다’로 넘기다 아무도 모르는 프로젝트가 됐다”는 경험담이 있었습니다. 반론 쪽은 모델이 사용자 기준만큼 좋아지면 이런 걱정은 사라진다고 봤습니다.
나머지 7건은 각자의 실천법이었습니다. 에이전트와 끝까지 논쟁한다, 시스템은 내가 설계하고 모듈 하나씩만 맡긴다, 백엔드는 줄마다 보고 화면 코드는 덜 본다는 식입니다. 정작 오스마니의 11월 글은 해커뉴스에 두 번 올라왔지만 댓글이 하나도 없었습니다.
같은 팀이 리뷰를 어떻게 기계로 옮겼는지는 앞서 다룬 Claude Code 팀 코드 리뷰 글에 숫자로 정리했습니다. 개발자에게 남는 역량에 대한 다른 시각은 앤드류 응 AI 엔지니어링 글에서 볼 수 있습니다.
본문 그래프 2점은 Shaw·Nave 논문 PDF의 수치로 다대구가 직접 계산·작성했습니다. 대표 이미지: 다대구 생성 이미지.